Reglas de asociación y Data mining: de Apriori al descubrimiento autónomo con IA
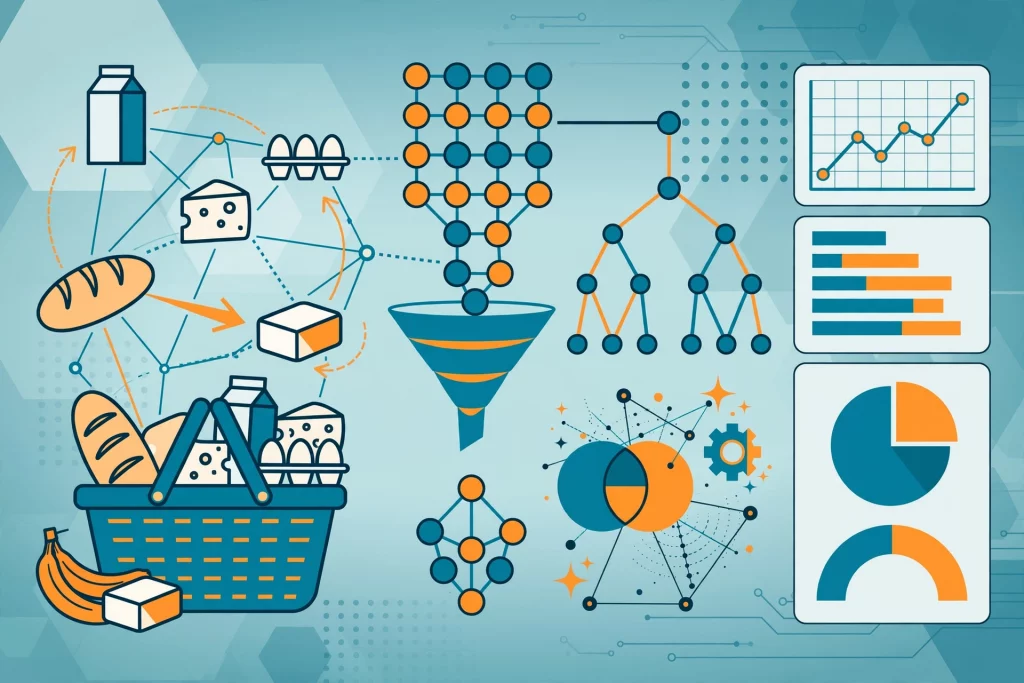
Las reglas de asociación son una técnica clásica de data mining con gran valor en retail, banca y logística. Por ejemplo, descubren que si un cliente compra pan → también suele comprar mantequilla (market basket analysis). La idea, formalizada a mediados de los 90 con algoritmos como Apriori y FP-Growth, sigue vigente. Sin embargo, en 2026 já no se ejecuta como un script nocturno. Ahora bien, forma parte de arquitecturas agentes que descubren patrones en streaming. Así, las reglas se despliegan en tiempo real. Aquí verás cómo reglas de asociación data mining agentes convergen hoy en un solo flujo de descubrimiento continuo.
El objetivo de este artículo es doble. Primero, explicar qué son las reglas de asociación y las métricas que las hacen fiables (support, confidence, lift). Después, mostrar cómo el data mining ha evolucionado en la práctica de BAOSS. Concretamente, hacia el descubrimiento autónomo orquestado por agentes.
¿Qué son las reglas de asociación? Conceptos clave
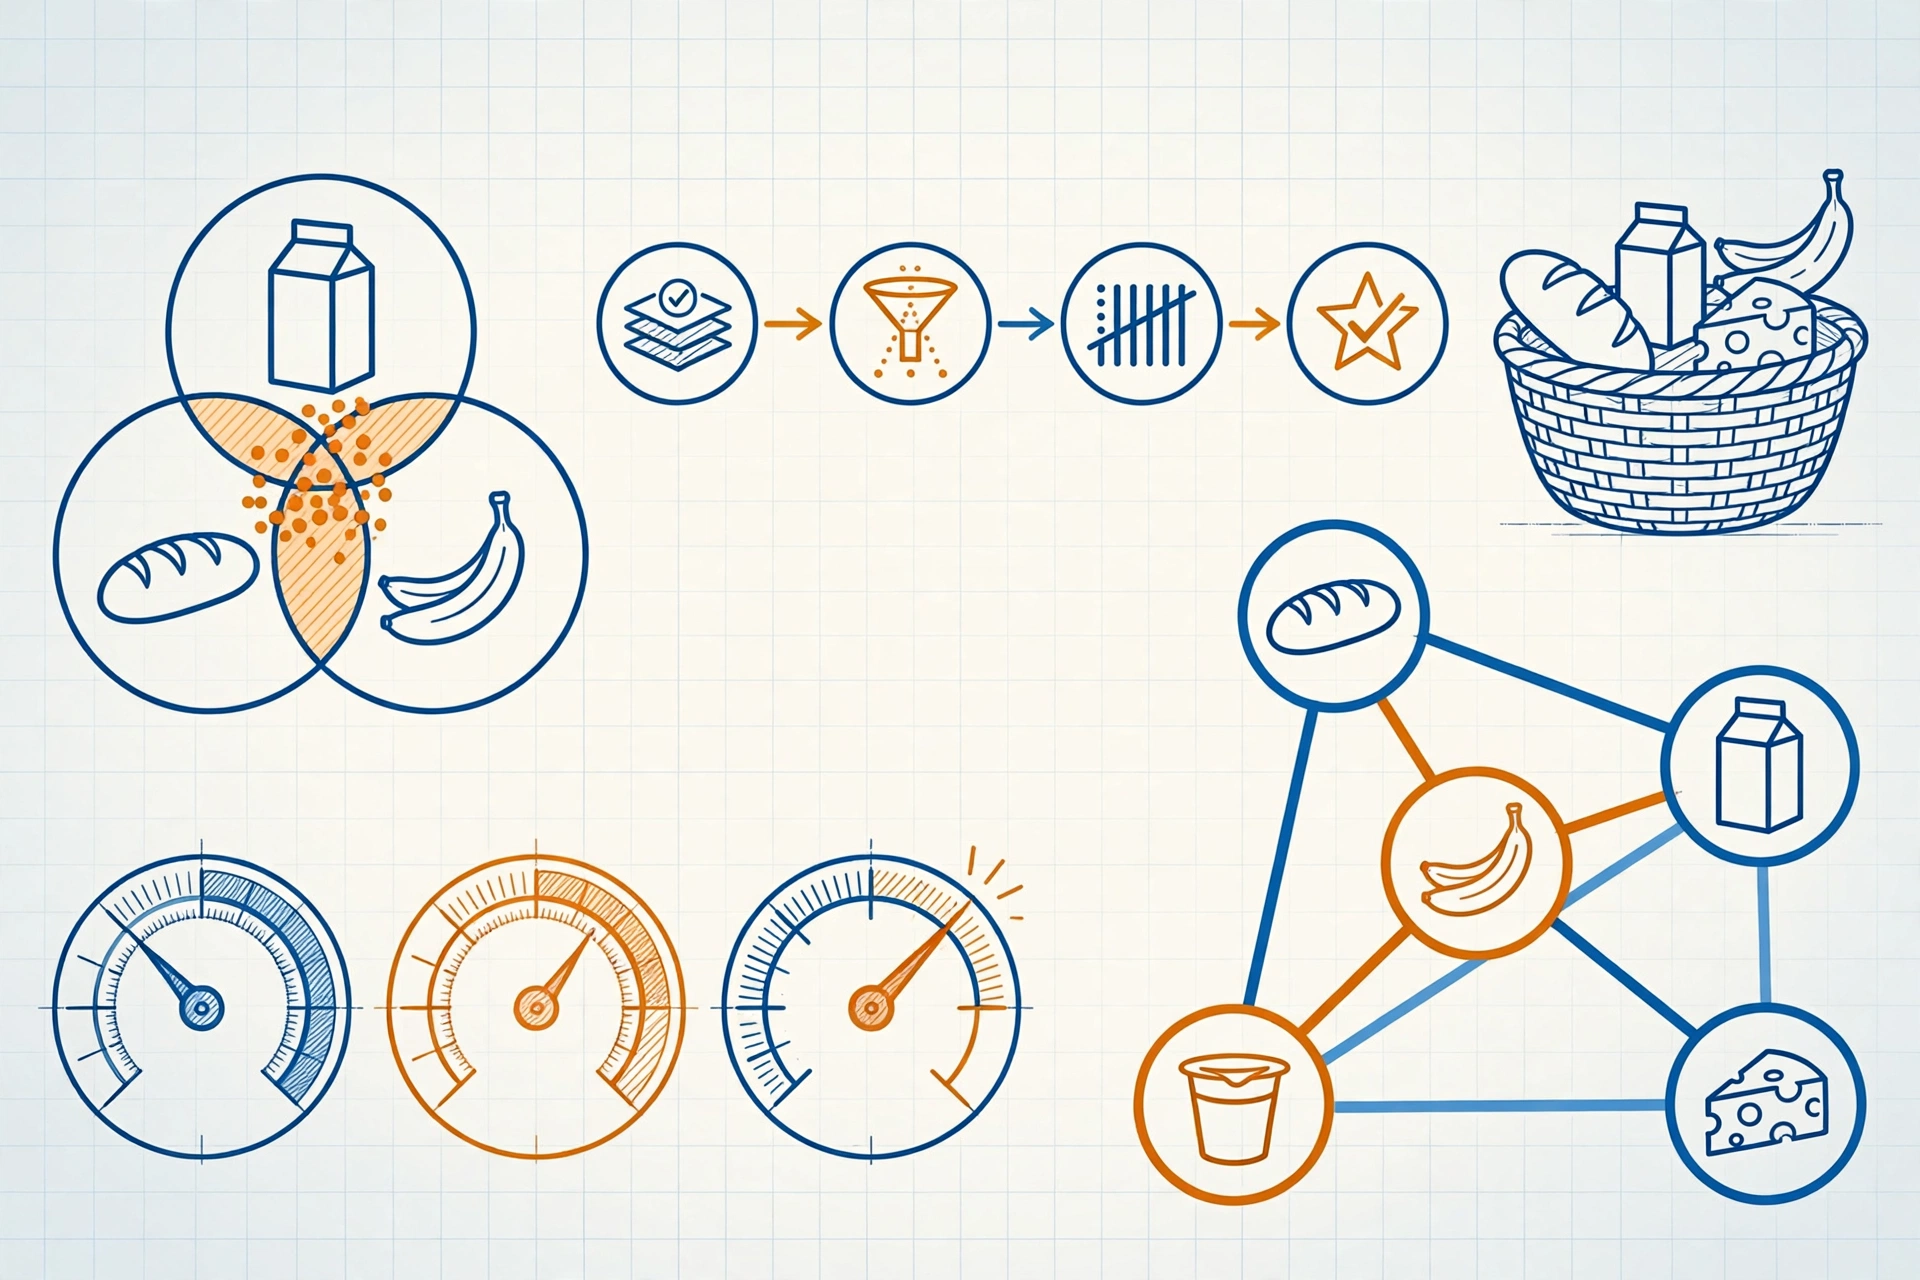
En el mining de reglas de asociación partimos de una base de transacciones (cestas de compra, sesiones web, siniestros). Una regla tiene la forma {A} → {B} y se evalúa con tres métricas:
- Support (soporte): frecuencia con que aparece el itemset {A,B} entre todas las transacciones. Filtra reglas poco frecuentes.
- Confidence (confianza): probabilidad condicional P(B|A) —de las transacciones con A, ¿cuántas incluyen B?.
- Lift (elevación): qué más probable es B cuando está A que al azar. Lift > 1 = asociación real; = 1 = independencia. Es la métrica más útil para descartar correlaciones espurias.
Algoritmos clásicos: Apriori (genera itemsets frecuentes por niveles con la propiedad antimonotónica) y FP-Growth (árbol compacto sin generar candidatos). Además, en Python dispones de las implementaciones de mlxtend y pyfpgrowth.
Reglas de asociación data mining agentes: el problema real 2026 de la minería batch al descubrimiento continuo
Las reglas clásicas (support, confidence, lift) siguen siendo matemáticamente válidas, pero escalan mal en entornos streaming con esquemas mutables. Un retailer con 12M transacciones/día y un catálogo dinámico (SKU rotación 23%/mes) no puede reentrenar Apriori cada noche. Tampoco puede mantener reglas que caducan por concept drift.
Según Gartner, el 78% de las empresas españolas sufre «parálisis analítica»: tienen más datos que nunca (crecimiento medio 42% interanual). Sin embargo, el time-to-insight aumenta. La razón: los equipos dedican gran parte del tiempo a limpiar y reconciliar versiones contradictorias de la verdad. La respuesta no es abandonar el data mining. Por el contrario, es orquestarlo con agentes. Así, los patrones se descubren, validan y despliegan en horas, no en semanas. Esa parálisis es un síntoma de disrupción: agentes de IA, ¿está tu empresa expuesta al golpe?
De KDD a Agentic Discovery: la pila técnica 2026
El proceso KDD (Knowledge Discovery in Databases) de 1996 cubría selección, preprocesamiento, transformación, minería y evaluación. Hoy, ese proceso se ha comprimido en bucles de retroalimentación autónomos orquestados por LangGraph, CrewAI o AutoGen. Cuando esos bucles tocan datos de clientes, aparece el riesgo de los agentes de IA: sin control, un patrón descubierto puede convertirse en decisión sesgada.
- Agente Planner (GPT-4o / Claude 4 Opus): recibe objetivos de negocio en lenguaje natural. Por ejemplo: «detecta cross-sell oculto en canal online». Después, los descompone en sub-tareas.
- Agente Researcher: consulta vector stores (Qdrant, Pinecone) y knowledge graphs (Neo4j) para contextualizar entidades y productos.
- Agente Miner (Python + mlxtend/pyfpgrowth/River para streaming): ejecuta el mining de reglas con hyperparameter search bayesiano (Optuna). Después, valida la significancia estadística.
- El Agente Validator (LLM-as-judge + causal inference): comprueba si la regla genera lift real en un A/B test simulado. Además, descarta correlaciones espurias.
- Agente Deployer (MCP + vLLM/Ollama): publica las reglas como feature flags en el feature store (Feast, Tecton). Después, notifica a stakeholders con explicabilidad SHAP/LIME.
El resultado: ciclos de descubrimiento de 3-4 semanas a 4-6 horas, con human-in-the-loop solo para la validación estratégica final.
Herramientas 2026: más allá de RapidMiner y Weka
| Categoría | Legado (2021) | Estándar 2026 | Cuándo usarlo |
|---|---|---|---|
| Orquestación agentes | — | LangGraph, CrewAI, AutoGen, Semantic Kernel | Pipelines multi-paso con state y human-in-the-loop |
| Minería de reglas | RapidMiner, Weka | mlxtend, pyfpgrowth, River, creme, scikit-multiflow | Itemsets frecuentes, streaming y concept drift |
| RAG / Retrieval | — | LlamaIndex, Haystack 2.0, LangChain, GraphRAG | Contexto empresarial sobre datos privados |
| Inferencia local | — | vLLM, Ollama, TGI, llama.cpp | Privacidad, latencia <100ms, coste controlado |
| Feature Store | — | Feast, Tecton, Hopsworks | Reglas como features en ML downstream |
| Observabilidad | Logs básicos | LangSmith, Arize Phoenix, MLflow 3.0 | Trazabilidad completa agente → regla → decisión |
Nota clave: Python sigue siendo el lingua franca (pandas 2.2+, Polars para out-of-core, DuckDB para OLAP embebido). Sin embargo, el diferencial competitivo está en la capa de orquestación, no en el algoritmo de minería per se.
Casos BAOSS: métricas reales, clientes anonimizados
Caso 1: Retail — Next best action con reglas de asociación en streaming
Reto: 12M transacciones/día, catálogo de 340 productos, modelo batch con lift 1.34x decayendo por concept drift.
Solución: Agente Miner con River (aprendizaje streaming, ventanas de 15 min) + Feast feature store. El agente Validator ejecuta evaluación contrafactual diaria contra un holdout del 5%.
- Lift sostenido 2,87x (vs 1,34x batch) — +114% conversión cross-sell.
- Latencia decisión < 80 ms (p99), compatible con real-time bidding.
- Reducción 63% falsos positivos gracias a validación causal del agente.
- ROI 4,2x en 5 meses.
Caso 2: Logística last-mile — patrón de demanda oculta con reglas espaciotemporales
Reto: 1.200 vehículos, 45.000 entregas/día, 38% rutas subóptimas por demanda no modelada (eventos locales, clima, flash sales).
Solución: El agente Miner aplica sequential pattern mining (PrefixSpan adaptado a streaming) sobre datos de geolocalización y eventos. Después, las reglas se inyectan en el optimizador OR-Tools como soft constraints con pesos dinámicos.
- Reducción 18,7% km/entrega — 2.840 tCO₂/año evitadas.
- Mejora 34% SLA entrega < 2h (92% → 98,3%).
- Despliegue de nuevas reglas en 2,3h (vs 11 días manuales).
- Payback 3,1 meses.
Caso 3: Seguros — Fraud ring detection con reglas de asociación sobre grafos
Reto: 2,8M pólizas, 145K siniestros/año. Redes de fraude organizado (staged accidents, clinic mills) invisibles para reglas univariantes; false negative rate estimado 31%.
Solución: Knowledge graph (Neo4j) con asegurados, vehículos, talleres, clínicas, peritos y abogados. El agente Miner aplica association rule mining sobre grafos (AMIE+, AnyBURL). Por ejemplo, detecta patrones como «mismo abogado + misma clínica + 3+ siniestros en 60 días + talleres conectados por propiedad compartida». El agente Validator prioriza por valor esperado de investigación.
Resultados (8 meses):
- Redes de fraude identificadas en 1/3 del tiempo previo.
- False negative rate: 31% → 9%.
- Ahorro estimado en pagos fraudulentos evitados: 2,3M€/año.
- ROI 3,8x (infra + agentes + reingeniería de canal de investigación).
Conclusión: de la regla de asociación al patrón desplegado
Las reglas de asociación no han muerto: se han absorbido como un skill más dentro de los agentes de minería. El Apriori que antes corría cada noche hoy convive con minería streaming (River). Además, convive con lift validado por causal inference y con reglas publicadas como features en producción. La técnica clásica aporta la base teórica; la orquestación agente aporta la velocidad, la validación y el despliegue. Esta capa de agentes sobre tus datos es el núcleo de BAOSS, el sistema operativo para agentes de negocio.
En BAOSS diseñamos e implantamos esa capa con métricas (lift, ROI, time-to-insight) y gobernanza para AI Act. Esa capa va del itemset frecuente al patrón desplegado en streaming.
¿Quieres pasar del mining batch a reglas de asociación en tiempo real con agentes? Habla con nuestro equipo de consultoría.