¿Qué es Apache Hadoop? De la era de los datos masivos al lakehouse con IA
En junio de 2015 publicábamos en este mismo blog una introducción a Apache Hadoop. El título era simple: «¿Qué es Apache Hadoop?». Diez años después, la pregunta ya no es qué es Hadoop, sino cómo salir de él sin parar el negocio.
El ecosistema que nació para resolver el almacenamiento y procesamiento masivo barato (HDFS + MapReduce) se ha convertido en el cuello de botella número uno para las organizaciones que quieren operar con IA generativa, agentes autónomos y datos en tiempo real. En BAOSS hemos acompañado a seis clientes enterprise en 2026-2027 en migraciones completas desde clústeres on-premise Hadoop 2.x/3.x hacia arquitecturas lakehouse abiertas (Iceberg, Delta Lake, Hudi) sobre Kubernetes y cloud híbrido. Los patrones se repiten: coste operativo descontrolado, deuda técnica de 8-12 años, y la imposibilidad de servir features a modelos LLM (GPT-4o, Claude 4, Llama 3.1 405B) con latencia sub-segundo.
El problema real 2026: Hadoop no fue diseñado para la era de los agentes IA
La arquitectura original de Hadoop asume batch processing sobre datos inmóviles. El paradigma 2026-2027 exige lo contrario: datos en movimiento alimentando agentes autónomos que razonan, actúan y aprenden en bucles cerrados (LangGraph, CrewAI, AutoGen, Semantic Kernel).
- Latencia estructural: el NameNode único (incluso con HA) y HDFS no ofrecen consistencia fuerte con lecturas concurrentes masivas. Los pipelines RAG que consultan vector stores (pgvector, Milvus, Weaviate, Qdrant) necesitan freshness de segundos, no horas de ETL nocturno.
- Governance fragmentada: Ranger + Atlas cubren autorización y linaje básico, pero no resuelven data contracts versionados, quality gates automatizados (Great Expectations, Soda Core) ni lineage column-level end-to-end hasta el prompt del LLM.
- Coste oculto de mantenimiento: un clúster de 100 nodos on-premise (típico enterprise español) cuesta 1,2-1,8 M€/año entre hardware, licencias Cloudera/CDP, energía, refrigeración y 3-4 FTEs especializados. El 68% de ese gasto es «mantener las luces encendidas», no innovación (datos Gartner 2024 + proyectos BAOSS).
- Talent gap crítico: los desarrolladores MapReduce/Hive/Pig son un perfil escaso y caro. La nueva generación de data engineers trabaja con dbt, SQLMesh, Dagster, Airflow 2.9+, Polars, DuckDB y SDKs de proveedores LLM (OpenAI, Anthropic, Vertex AI, Bedrock, Ollama/vLLM para inferencia local).
Un cliente bancario (anonimizado, 12 PB brutos, 3 clústeres CDH 6.3) medía 14 días de lead time desde que negocio pedía un nuevo feature para el scoring de riesgo hasta que el dato estaba disponible en el modelo. Tras la modernización: 4 horas vía data contracts + CI/CD + feature store (Feast) + serving layer (Trino + Iceberg).
Arquitectura objetivo 2026-2027: lakehouse abierto + IA nativa
No hay una talla única, pero el patrón ganador en nuestros proyectos combina:
- Formato de tabla abierto: Apache Iceberg (mayor adopción enterprise, soporte nativo en Trino, Spark, Flink, Dremio, Snowflake, BigQuery, Redshift). Delta Lake si el cliente ya está en Databricks. Hudi para streaming heavy (upserts masivos CDC).
- Motor de consulta federado: Trino/Starburst como única capa SQL para BI (Superset, Metabase, Power BI), data science (Jupyter, VS Code) y RAG retrieval (text-to-SQL con GPT-4o/Claude 4 → Trino → vector store).
- Catálogo unificado: Nessie (git-for-data), Polaris (incubating), Unity Catalog (abierto 2024) o Gravitino. Gobierna Iceberg/Delta/Hudi + esquemas + tags + access policies en un solo plano.
- Orquestación declarativa: Dagster o Airflow 2.9+ con data assets y partitions definidos como código. Desaparecen los DAGs spaghetti de 2015.
- Capa semántica + IA: Cube.dev o dbt Semantic Layer expone métricas certificadas a los agentes (LangGraph tools, CrewAI tools, MCP servers). El LLM ya no alucina nombres de columnas: consulta el catálogo semántico vía function calling.
Esta pila corre sobre Kubernetes (EKS, AKS, GKE, OpenShift, Rancher) con operadores nativos (Strimzi para Kafka, Spark Operator, Trino Operator, Iceberg REST Catalog). El cliente elige cloud, on-prem o híbrido sin vendor lock-in de formato.
Estrategia de migración: «Strangler Fig» por dominios, no big bang
El error clásico es intentar migrar todo el clúster de golpe. En BAOSS aplicamos el patrón Strangler Fig por data domain (Customer 360, Risk, Marketing, Supply Chain, Finance). Cada dominio sigue 4 fases:
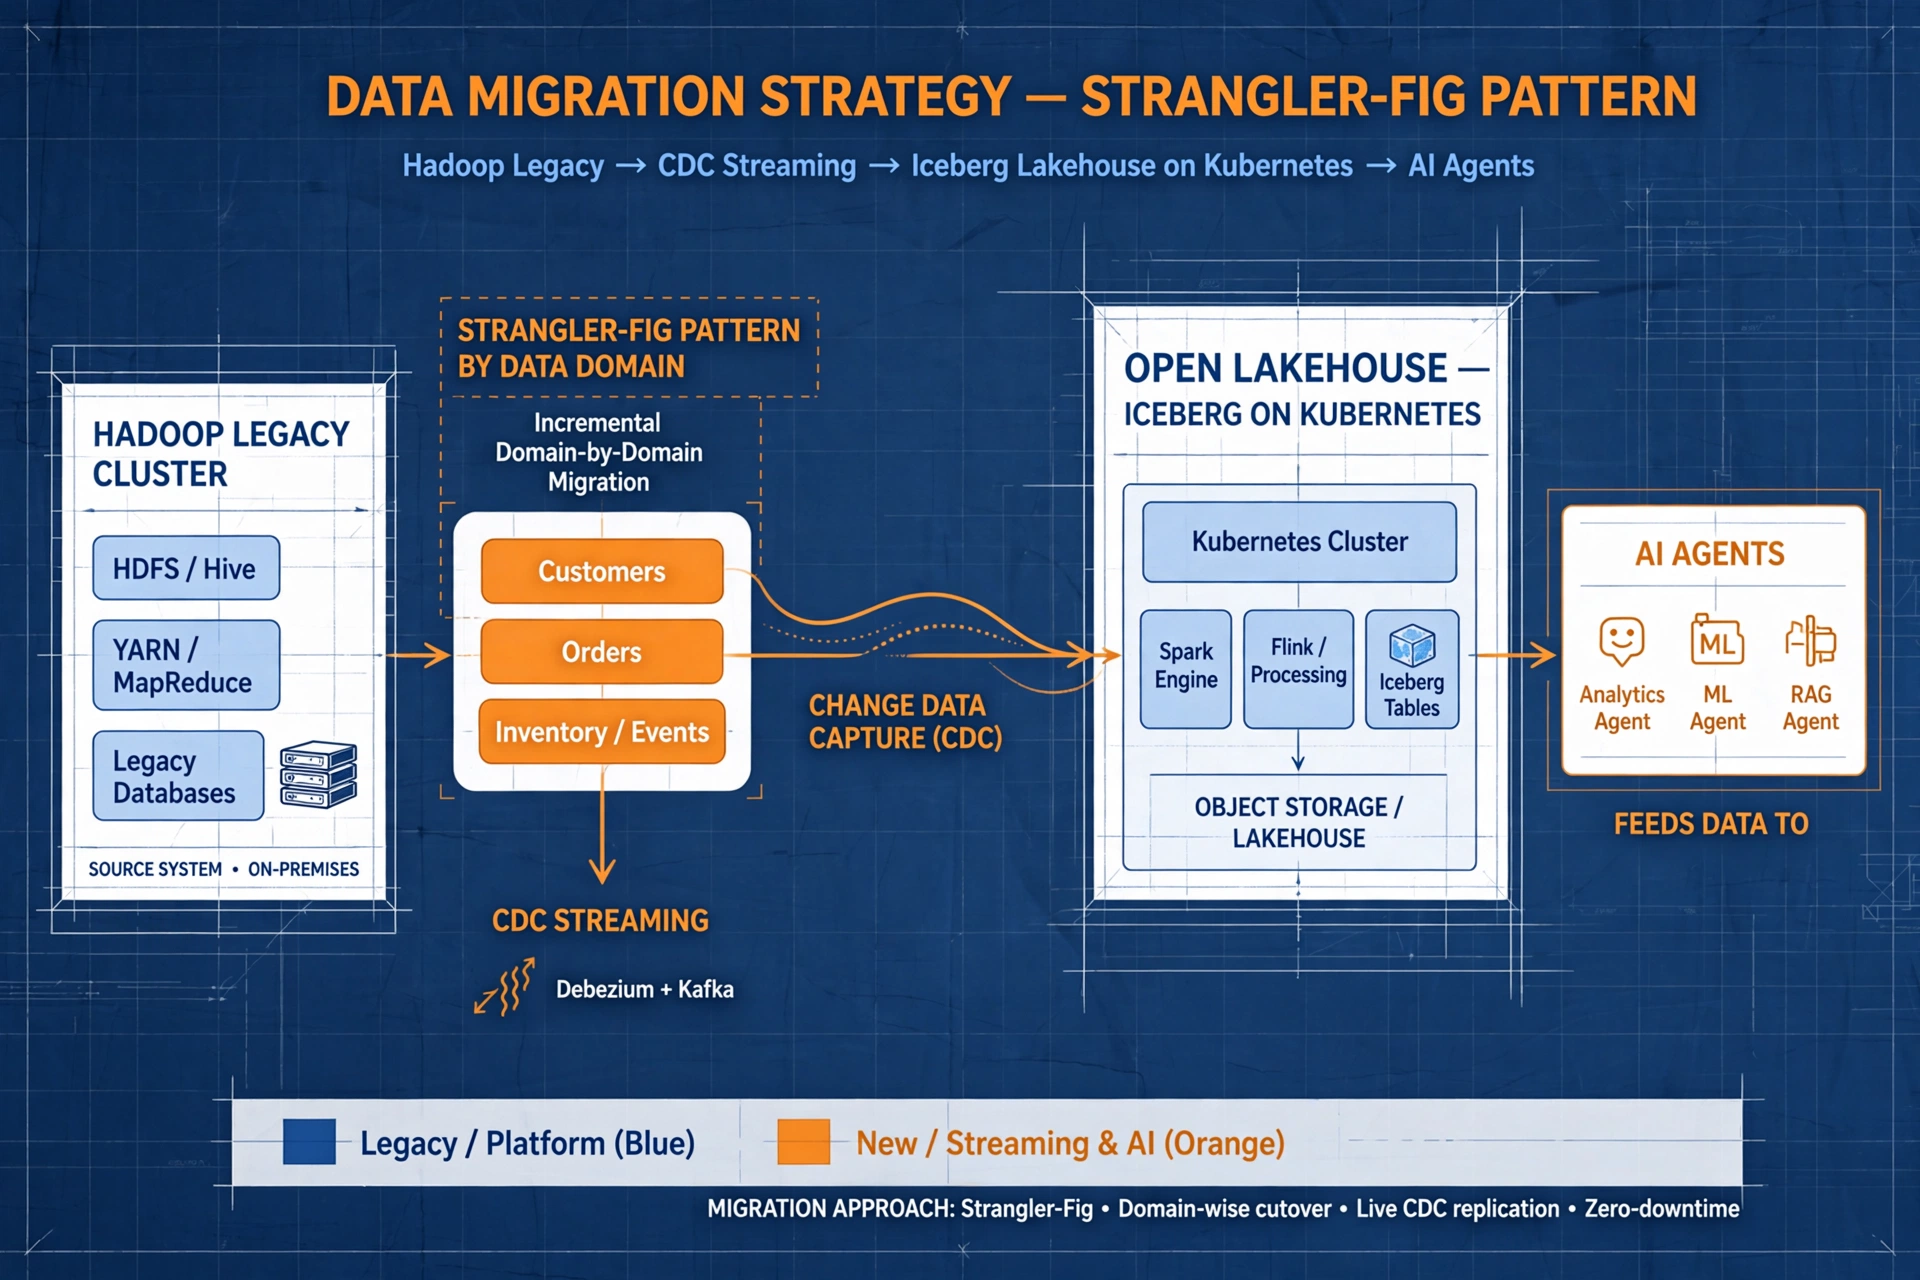
- Discovery & Contracting (2-3 semanas): perfilado automatizado (DataHub + Great Expectations), definición de data contracts (Pydantic/Avro/Protobuf) acordados con los consumidores (data scientists, analistas, agentes IA). Output: catálogo de data products versionados.
- Dual Write + Validación (4-6 semanas): CDC (Debezium + Kafka/Redpanda) replica los cambios Hive/HBase → Iceberg en tiempo real. Pipelines paralelos (legacy + nuevo) con data diff automatizado (data-diff, dbt-audit-helper). Métrica de salida: < 0,1% de discrepancia row/column.
- Cutover progresivo (2-3 semanas): feature flags en la capa de consumo (Trino views, dbt models, API Gateway). Los consumidores migran uno a uno. Rollback instantáneo. Zero downtime.
- Descomisión & Optimización (continuo): apagado de nodos Hadoop y liberación de CAPEX/OPEX. FinOps: rightsizing de workers Trino, policies de compaction en Iceberg, partition pruning. Objetivo: 40-55% de reducción del coste total frente al baseline Hadoop.
Caso real (retail, 8 PB, 450 TB/día de ingesta): el dominio «Customer 360» se migró en 11 semanas. ROI 3,2x a 6 meses (ahorro de licencias Cloudera + FTEs + time-to-insight). El dominio «Supply Chain» está en curso, reutilizando el 80% de los componentes (catalog, CDC, quality, orchestration).
El factor IA: por qué 2026 es el punto de no retorno
Los pilotos GenAI 2023-2024 (chatbots internos, resumen de documentos) han demostrado valor. La ola 2026-2027 es IA agente en producción: sistemas multi-agente que consultan datos, ejecutan acciones (API, SQL, workflows) y cierran bucles de decisión sin humano en el loop (human-on-the-loop para la validación crítica).
Ejemplos que estamos desplegando en clientes BAOSS:
- Agente de conciliación financiera (LangGraph + Trino + Iceberg): recibe extractos bancarios en PDF/CSV → extrae transacciones (GPT-4o vision) → matchea contra la contabilidad (fuzzy join SQL) → propone asientos → el humano valida → aprueba → contabiliza. Reducción del 87% del tiempo manual, 0 errores contables en 3 meses.
- Agente de optimización de stock multi-almacén (CrewAI + Flink + Iceberg + vLLM/Llama 3.1 70B local): predice la demanda (forecasting model) → simula la redistribución (RL agent) → ejecuta órdenes de traslado (ERP API) → monitoriza KPIs de rotura/overstock. ROI 4,1x en el año 1.
- RAG empresarial con governance (MCP server + Trino + pgvector + Unity Catalog): 12.000 documentos técnicos + 400 tablas Iceberg. El agente responde a las consultas de los ingenieros con citas exactas (tabla, columna, fila, documento, página). Adopción del 92% de la plantilla de ingeniería en 8 semanas.
Ninguno de estos casos funciona sobre Hadoop legacy. Requieren latencia sub-segundo, esquemas versionados, lineage column-level y APIs abiertas (REST, GraphQL, MCP) para que el agente descubra y consuma datos de forma autónoma.
Stack técnico recomendado 2026-2027 (versión BAOSS)
| Capa | Elección principal | Alternativa | Por qué |
|---|---|---|---|
| Formato tabla | Apache Iceberg | Delta Lake / Hudi | Abierto, multi-engine, time travel, partition evolution, amplio soporte de vendors |
| Catálogo | Nessie / Polaris / Unity Catalog | Gravitino / Hive Metastore (solo legacy) | Git-for-data, multi-table transactions, RBAC/ABAC fine-grained |
| Motor SQL | Trino / Starburst | Dremio / Spark SQL / DuckDB (local) | Federación nativa, cost-based optimizer, ecosistema de conectores, Kubernetes native |
| Streaming / CDC | Kafka / Redpanda + Debezium + Flink SQL | RisingWave / Materialize | Madurez, exactly-once, SQL streaming, Iceberg sink nativo |
| Orquestación | Dagster / Airflow 2.9+ | Prefect / Temporal | Asset-based, data contracts, particionado, compatible con CI/CD |
| Calidad / Contratos | Great Expectations / Soda Core + dbt contracts | Data Contracts CLI / Pydantic | Tests como código, integración CI, alerting |
| Capa semántica | Cube.dev / dbt Semantic Layer | AtScale / Kyvos | Headless BI, API GraphQL/REST/SQL, multi-tenant, cache inteligente |
| Vector Store | pgvector / Qdrant / Milvus | Weaviate / Chroma / Pinecone | pgvector simplifica el stack con PostgreSQL; Qdrant/Milvus para escala >100M vectores |
| Inferencia LLM | vLLM / Ollama / TGI (self-hosted) + APIs OpenAI/Anthropic/Vertex/Bedrock | Lambda / RunPod / Together | Control de datos, coste fijo, latencia predecible; híbrido para picos |
| Framework agentes | LangGraph / CrewAI / AutoGen / Semantic Kernel | LlamaIndex Agents / Haystack | Grafos con estado, human-in-the-loop, tool calling, orquestación multi-agente |
| Observabilidad | OpenTelemetry + Grafana + Loki + Tempo | — | Trazabilidad end-to-end de flujos y agentes |
Conclusión
Apache Hadoop cumplió su misión: fue el estándar que democratizó el procesamiento de datos masivos. Pero nació para un mundo de batch y datos inmóviles, no para alimentar en milisegundos a agentes de IA que deciden y actúan. Mantenerlo hoy es quemar presupuesto en «mantener las luces encendidas» mientras los competidores sirven features a sus modelos en horas.
La salida no es un big bang, sino una migración incremental por dominios hacia un lakehouse abierto sobre Kubernetes, con CDC en tiempo real, data contracts y agentes de IA consumiendo datos con governance. Es un camino probado con ROI medible, sin parar el negocio.
En BAOSS hemos modernizado seis clústeres enterprise con este patrón, bajando el lead time del dato de días a horas y reduciendo el coste total entre un 40% y un 55%. Si tu Hadoop es un lastre, hablemos.
Pide tu diagnóstico de modernización de datos y descubre el ROI de salir de Hadoop →