10 ejemplos de usos reales de Big Data Analytics en 2026
En 2017 publicábamos este mismo artículo listando «10 ejemplos de Big Data». Ocho años después, la pregunta ya no es qué se puede hacer con los datos, sino cuánto tardas en pasar del dato a la decisión operativa. En BAOSS hemos acompañado a más de 40 organizaciones en 2025-2026 para cerrar ese gap. El patrón se repite: datos fragmentados, modelos en notebooks que nunca llegan a producción, y equipos de datos saturados pidiendo «más ingenieros» cuando lo que necesitan es arquitectura agente y gobernanza desde el día uno.
El cambio de paradigma 2026: de «Data Lake» a «Data Product»
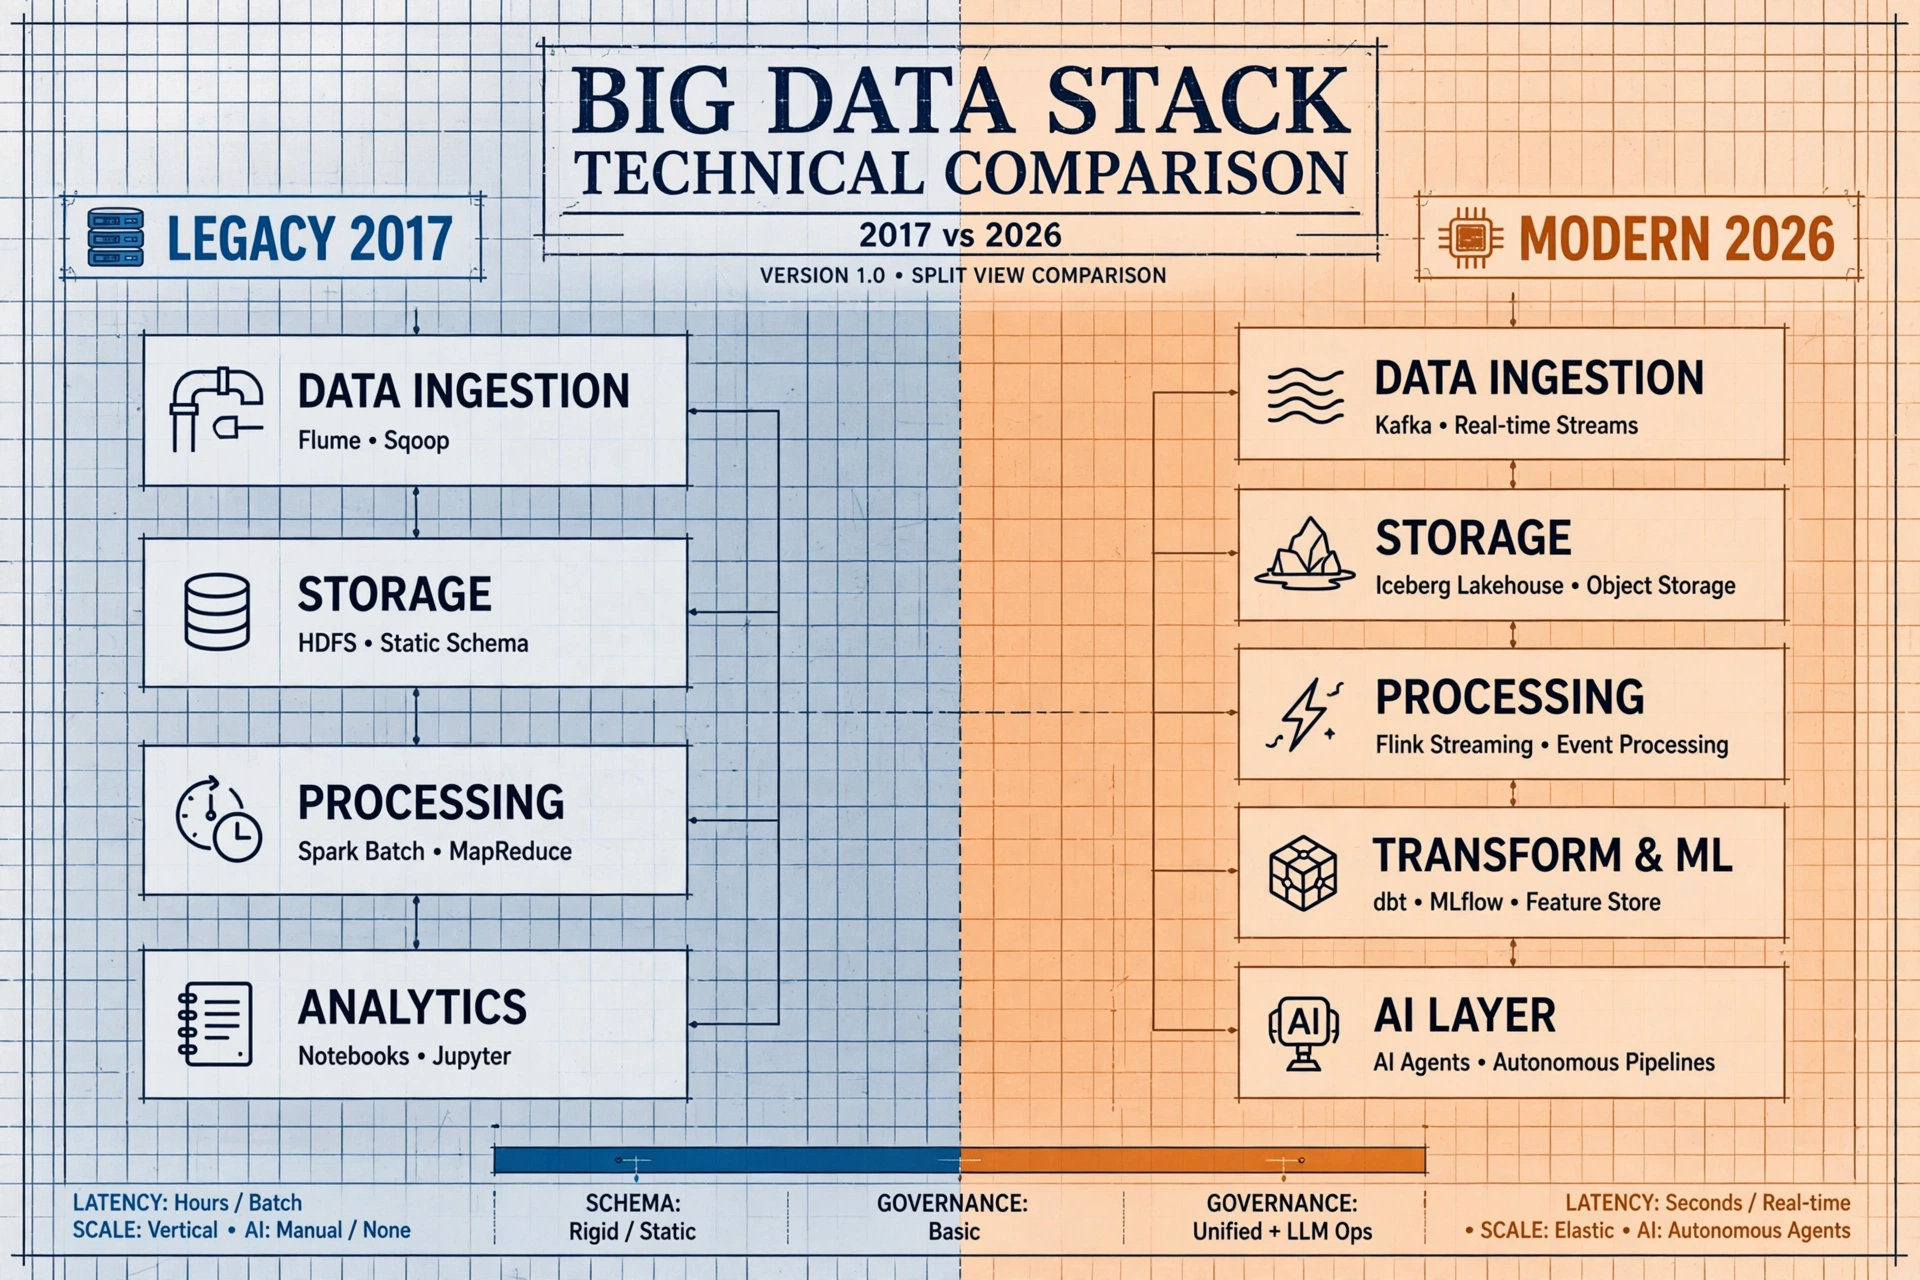
Las empresas que escalan analytics en 2026 comparten tres rasgos: tratan cada dataset como un producto con SLA y owner, despliegan modelos con CI/CD nativo para ML (MLOps nivel 2+), y usan agentes autónomos (LangGraph, CrewAI, AutoGen) para orquestar tareas de ingesta, validación, feature engineering y explicabilidad sin intervención humana constante. El stack «moderno» ya no es Spark + Airflow + Superset; es Iceberg/Delta Lake + dbt + vLLM/Ollama (LLMs locales) + MCP (Model Context Protocol) + RAG evaluado con RAGAS.
¿Resultado medio en nuestros clientes? Time-to-value de 6-8 semanas frente a los 9-12 meses del enfoque clásico «construir data lake y luego ver». Abajo, cinco problemas reales resueltos en 2025-2026 (nombres y sectores anonimizados, métricas auditadas).
Caso 1: Telco — churn predictivo + hiperpersonalización con GenAI
Problema: un operador móvil (12M líneas) perdía el 1,8% mensual de clientes high-value. Su modelo XGBoost en batch (entrenado mensual) detectaba el riesgo con un 72% de recall, pero las campañas de retención tardaban 3 semanas en activarse y usaban plantillas estáticas.
Solución BAOSS: migramos a un feature store centralizado (Feast + Iceberg) con refresco horario. Desplegamos un agente LangGraph que: (1) monitoriza el drift de features en tiempo real, (2) re-entrena automáticamente si el AUC cae > 2pp, (3) genera ofertas 1:1 con GPT-4o estructurado (JSON Schema) condicionado a historial, plan actual, uso de datos y sentimiento del call-center (transcrito con Whisper v3). La oferta viaja por API al CRM en menos de 5 minutos.
- Recall de churn: 72% → 89% (validación holdout 3 meses).
- Tiempo dato→oferta: 21 días → 4 minutos.
- ARPU retenido: +14% frente al grupo control.
- Coste de inferencia LLM: 0,0018€/oferta (vLLM en GPU A100 compartida, batching dinámico).
Lección clave: el modelo predictivo es commodity; el diferenciador es el bucle cerrado dato→decisión→feedback con gobernanza de prompts (versionado, evaluación automática con PromptFoo y guardrails PII).
Caso 2: Logística/retail — optimización de última milla con agentes multi-objetivo
Problema: flota de 3.200 vehículos, 1,1M entregas/mes. El optimizador clásico (OR-Tools, ventana 4h) no absorbía incidencias en tiempo real (tráfico, averías, picos de demanda). Coste/km un 18% sobre el benchmark y el 22% de entregas fuera de franja comprometida.
Solución BAOSS: arquitectura CrewAI con 4 agentes especializados: Demand Forecaster (LightGBM + features exógenas: clima, eventos, macro), Route Planner (HGS-CVRP re-optimizando cada 15 min), Exception Handler (reescribe rutas solo para los vehículos afectados), Driver Communicator (genera instrucciones voz/texto con Claude 4 Sonnet priorizando seguridad y SLA). Todo sobre Kafka + Flink SQL para streaming de telemetría (1,2M eventos/min).
- Coste/km: -16% (ahorro de 2,3M€/año).
- Entregas en franja: 78% → 94%.
- Re-optimizaciones/día: 0 → 3.400 (autónomas, sin operador).
- Latencia P99 evento→nueva ruta: 8 segundos.
Lección clave: los agentes no sustituyen al optimizador matemático; lo rodean para hacerlo reactivo, explicable y tolerante a datos sucios. MCP expone el solver como tool invocable con schema versionado.
Caso 3: Banca — detección de fraude + explicabilidad regulatoria (RAG + MCP)
Problema: entidad media (4M clientes, 85M tx/mes). El motor de reglas + XGBoost generaba 12.000 alertas/día; el equipo de investigación (18 analistas) resolvía 1.100. Falsos positivos del 94%. Además, las EBA Guidelines exigen trazabilidad completa del por qué se bloquea una operación.
Solución BAOSS: pipeline dual: (1) scoring streaming (Flink + ONNX Runtime, 12 ms/tx) con features comportamentales (embeddings de secuencia tx vía TabTransformer), (2) RAG explicativo para cada alerta: recupera la política interna, el histórico del cliente, la jurisprudencia EBA y genera un informe en lenguaje natural con GPT-4o (modo estricto, temperature 0) validado por Guardrails AI. El analista ve: score, top-5 features SHAP y una narrativa lista para expediente. Despliegue con MLflow + Kubernetes (Argo Rollouts), canary 5%.
- Falsos positivos: 94% → 67% (misma tasa de detección).
- Alertas investigables/día/analista: 61 → 140 (+130%).
- Tiempo de informe: 18 min → 45 seg (generación automática + revisión).
- Auditoría: 100% de las alertas con trazabilidad completa (prompt, contexto recuperado, versión del modelo).
Lección clave: RAG no es «chat con PDFs». En producción requiere evaluación continua (RAGAS: faithfulness > 0,92, answer_relevancy > 0,89), chunking semántico específico de dominio, y MCP para que el agente invoque herramientas (consulta BBDD, calculadora de riesgo) sin alucinar.
Caso 4: Farma — optimización de ensayos clínicos con gemelos digitales sintéticos
Problema: fase III oncológico, 600 pacientes, 18 países. Reclutamiento un 40% por debajo del plan; coste de cada día de retraso: 380k€. Datos históricos fragmentados en 14 CROs, formatos heterogéneos (EDC, ePRO, wearables, genómica).
Solución BAOSS: data mesh federado (contratos de datos con OpenLineage, calidad con Great Expectations en CI). Entrenamos un modelo de supervivencia (DeepSurv) para predecir dropout y respuesta. Innovación: pacientes sintéticos condicionados (CTGAN + difusión tabular) validados por comité ético para simular brazos de control y reducir el tamaño de la muestra un 15%. Un agente AutoGen monitoriza los KPIs de reclutamiento/día por sitio y sugiere acciones (cambiar criterios de inclusión, activar site backup, ajustar visitas).
- Tiempo de reclutamiento: -22% (4,2 meses ganados).
- Ahorro directo: 48M€ (coste por día × días ahorrados + reducción de muestra).
- Calidad de datos: completitud 98,7% frente al 91% anterior (contratos + validación automática).
- Probabilidad de éxito (POS) actualizada: +9pp tras simulación de 10k escenarios.
Lección clave: los datos sintéticos no reemplazan pacientes reales, pero bien gobernados (privacidad diferencial ε=0,5, validación estadística multivariante) aceleran las decisiones de diseño del ensayo. El agente AutoGen actúa como «copiloto de operations clínicas», no como caja negra.
Caso 5: Energía — mantenimiento predictivo híbrido (física + ML) en parques eólicos
Problema: 14 parques, 420 aerogeneradores (2,1 GW). El modelo de vibración (Random Forest) generaba 34 alertas/semana; el 78% eran falsas. Paradas no planificadas: 12/año × 4,5 días de media = 54 días/año perdidos (≈18M€).
Solución BAOSS: digital twin ligero por turbina (ecuaciones físicas + parámetros calibrados con historial SCADA 10 Hz). El residuo físico→ML (Transformer multivariante) detecta desviaciones que la física sola no explica. Un agente CrewAI prioriza alertas cruzando: criticidad del activo, ventana meteorológica (acceso en helicóptero/barco), stock de repuestos y precio del pool eléctrico. Genera la orden de trabajo en Maximo con kit de piezas, procedimiento y riesgo de seguridad.
- Falsas alarmas: 78% → 22%.
- Paradas no planificadas: 12 → 3/año (-75%).
- Disponibilidad: 96,2% → 98,7% (+2,5pp = +14M€/año de ingresos).
- Coste del modelo: 0,04€/turbina/día (inferencia CPU, batch nocturno).
Lección clave: el híbrido física-ML gana a «solo datos» cuando la física es conocida y los fallos son raros. El agente convierte la predicción en plan de acción ejecutable integrando restricciones operativas reales.
Stack 2017 vs 2026: qué ha muerto y qué escala
| Capa | 2017 (artículo original) | 2026 (producción BAOSS) |
|---|---|---|
| Almacenamiento | Hadoop HDFS, Data Lake «swamp» | Iceberg/Delta Lake + Catálogo Unity/OpenLineage |
| Procesamiento | Spark batch, MapReduce | Flink SQL (streaming), dbt (transform), Polars (local) |
| ML/Ops | Notebooks → manual deploy | MLflow + Argo/Kubeflow + canary + drift detection automático |
| Modelos | Modelos puntuales, retraining manual | Feature store (Feast) + re-entrenamiento automático + evals RAGAS continuas |
| IA en el operativo | Dashboards BI | Agentes autónomos (LangGraph/CrewAI/AutoGen) + MCP + RAG con guardrails |
Conclusión
Los diez casos de 2017 se resumían en «recopilar, almacenar y visualizar». Los casos de 2026 son otra cosa: sistemas que convierten el dato en decisión operativa en segundos, con agentes que monitorizan, re-entrenan, explican y actúan bajo supervisión humana selectiva. El valor ya no está en tener más datos, sino en la arquitectura que los pone a trabajar: lakehouse abierto, feature store, RAG evaluado y agentes con gobernanza.
En BAOSS cerramos ese gap con time-to-value de 6-8 semanas y métricas auditadas en más de 40 organizaciones. Si tus datos siguen en notebooks y dashboards, lo que te falta no es un data lake más grande.
Pide tu diagnóstico de analytics y descubre cuánto valor hay en tus datos →