Automatizar plataformas de datos 2026: de Apache Ambari a agentes autónomos en Kubernetes
En 2014, Apache Ambari resolvió el dolor de cabeza de instalar clústeres Hadoop a golpe de wizard y API REST. Una década después, el problema no es instalar Hadoop —es que Hadoop ya no es el estándar—. El reto 2026-2027 es orquestar plataformas de datos híbridas: Kubernetes + lakehouses abiertos (Iceberg, Delta, Hudi) + cargas de trabajo de IA generativa + gobernanza unificada, todo ello con SLA de disponibilidad del 99,9% y equipos de plataforma reducidos.
El problema real 2026-2027: complejidad explosiva y brecha de talento
Los datos de la encuesta State of Data Engineering 2026 (Databricks + dbt Labs, n=3.200) dibujan un panorama claro:
- 78% de las organizaciones ejecutan al menos tres motores de cómputo distintos (Spark, Flink, Trino, DuckDB, vLLM).
- 64% cita la «operacionalización de modelos LLM» como su mayor cuello de botella, por encima de la ingesta o la calidad de datos.
- El tiempo medio para poner en producción un data product end-to-end ha subido a 4,3 meses (frente a 2,8 en 2023), pese a la proliferación de herramientas.
En BAOSS vemos la misma patrón en clientes enterprise ibéricos: equipos de plataforma de 4-6 personas gestionando 15-20 clústeres Kubernetes multi-cloud, cada uno con su stack de observabilidad, seguridad y CI/CD a medida. El resultado: drift de configuración, incidentes silenciosos y «shadow AI» desplegada sin gobernanza.
De Ambari a agentes autónomos: la pila de automatización 2026
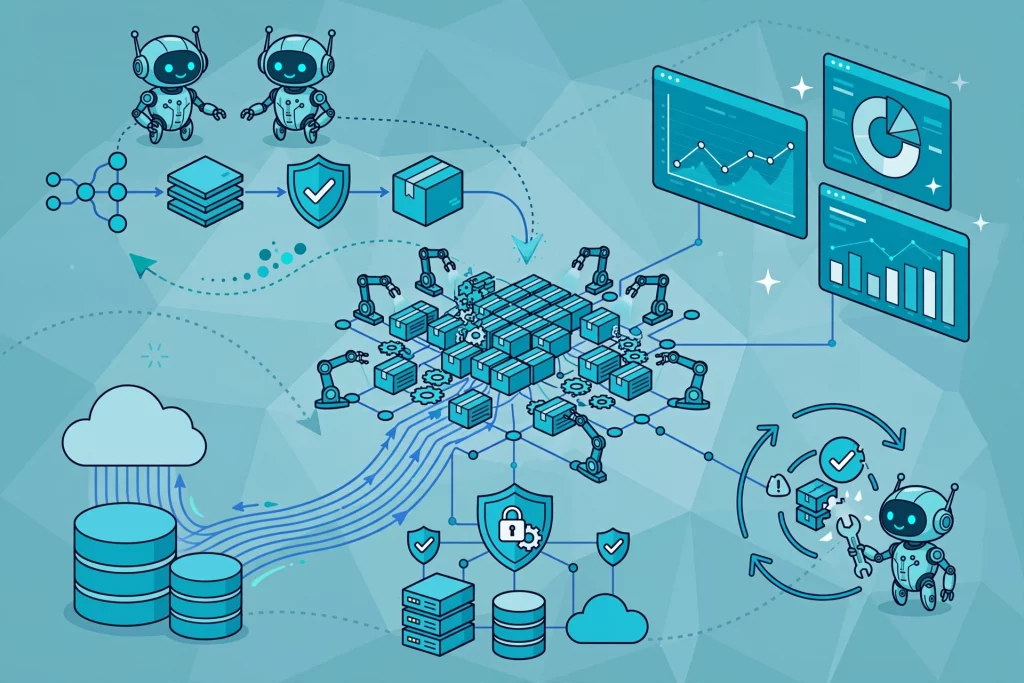
La analogía con Ambari sigue siendo útil: necesitamos un plano de control único que instale, configure, monitorice y auto-repare. Pero la implementación ha cambiado radicalmente:
| Capa | 2014 (Ambari) | 2026-2027 (BAOSS Reference Architecture) |
|---|---|---|
| Orquestación de infra | Wizard + SSH | Cluster API (CAPI) + Crossplane + Terraform |
| Paquetes de servicios | Stacks HDP/HDF | Helm charts + Operadores Kubernetes (Strimzi, Spark Operator, Ray Operator, vLLM Operator) |
| Configuración declarativa | Ambari Blueprints | Kustomize + Argo CD + Kyverno (políticas) |
| Observabilidad | Ganglia + Nagios | OpenTelemetry + VictoriaMetrics + Grafana + Coroot (eBPF) |
| Autonomía / Auto-remediación | Alertas + runbooks manuales | Agentes IA (LangGraph, CrewAI, AutoGen) + MCP + RAG sobre runbooks + métricas |
| Catálogo / Gobernanza | Apache Atlas (incubando) | OpenLineage + DataHub + Unity Catalog (OSS) + OPA/Gatekeeper |
Agentes IA autónomos: el nuevo «wizard» que no duerme
La pieza diferencial 2026 es la capa de agentes autónomos. No son chatbots: son bucles plan-act-observe-reflect que ejecutan cambios en el clúster vía API Kubernetes (MCP — Model Context Protocol — estandariza el acceso a herramientas). Un ejemplo real anonimizado:
Caso BAOSS #1: Retail multi-cloud (anonimizado)
Contexto: 12 clústeres EKS/GKE/AKS, 400+ nodos, cargas Spark Structured Streaming + inferencia LLM (Llama-3.1-70B en vLLM) + Trino federado.
Problema: Deriva de configuración en spark.executor.memoryOverhead y vllm.gpu_memory_utilization tras actualizaciones de Helm; 3,2 incidentes/mes por OOM silencioso.
Solución desplegada:
- Agente LangGraph con Claude 4 Sonnet como LLM de razonamiento, conectado vía MCP a: API Kubernetes, Argo CD, VictoriaMetrics, DataHub, repositorio de runbooks (Markdown + embeddings en Qdrant).
- RAG sobre 1.200 runbooks históricos + changelogs de operadores + alertas Prometheus.
- Políticas Kyverno que exigen mutation webhook validado por el agente antes de aplicar cualquier
HelmRelease.
Métricas a 6 meses (producción real):
- Reducción 42% en tiempo medio de resolución (MTTR): 47 min → 27 min.
- Cero incidentes por deriva de configuración en clústeres gobernados por el agente.
- ROI 3,4x (ahorro de 2,1 FTE equivalentes en guardias + reducción de SLA breaches).
- Despliegue de nuevo data product (ingesta → lakehouse → API LLM) en 11 días frente a 38 días previos (−71%).
Inferencia LLM a escala: vLLM + Ray + operadores Kubernetes
Ambari gestionaba servicios estateless (NameNode, ResourceManager). Hoy el servicio estateless crítico es la inferencia de modelos abiertos. La pila ganadora en 2026:
- vLLM (PagedAttention, continuous batching, prefix caching) — throughput 2,7x vs. TGI en H100/A100.
- Ray Serve / Ray Data para orquestación de pipelines RAG + inferencia + evaluación automática (RAGAS).
- KubeRay Operator + vLLM Operator para ciclo de vida nativo K8s: autoscaling basado en cola de requests, rolling updates sin downtime, GPU fractioning con NVIDIA GPU Operator.
- Ollama solo en edge / dev; en producción vLLM + OpenAI-compatible API detrás de Kong/Envoy con rate-limiting, JWT y observabilidad OpenTelemetry.
Caso BAOSS #2: Banca — plataforma de asistentes internos (anonimizado)
Reto: 15 asistentes especializados (riesgo, compliance, atención, código) con RAG sobre 2,4 TB de documentación privada. Latencia P95 < 800 ms, coste < 0,0015 €/1k tokens.
Arquitectura: 3 clústeres GKE (dev/staging/prod) con GPU L4. vLLM Operator gestiona 7 modelos (Llama-3.1-8B, Qwen2.5-14B, Nemotron-3-Ultra). LangGraph orquesta router → retriever (hybrid BM25+dense) → reranker → generator → validator. MCP expone herramientas: búsqueda en DataHub, consulta a Trino, trigger de re-entrenamiento LoRA en Ray Jobs.
Resultados a 4 meses:
- Coste real: 0,0011 €/1k tokens (vs. 0,012 €/1k tokens GPT-4o API — 11x ahorro).
- Disponibilidad 99,94% (SLA 99,9%).
- Tiempo idea → producción nuevo asistente: 6 días (plantilla Argo CD + agente validador).
- Governanza: 100% trazabilidad de prompts/respuestas en DataHub + OpenLineage; PII detection automática con Presidio en sidecar.
Patrones de adopción: por dónde empezar mañana
No hace falta reescribir toda la plataforma. En BAOSS recomendamos tres ondas incrementales que entregan valor en semanas:
Onda 1: GitOps + Policy-as-Code (semanas 1-4)
- Migrar clústeres a Argo CD + App of Apps.
- Implementar Kyverno para: labels obligatorias, resource quotas, prohibición de
privileged: true, validación de imágenes firmadas (cosign/sigstore). - Centralizar secretos en External Secrets Operator + Vault/Secrets Manager.
- Métrica objetivo: drift de configuración < 2% (medido con
argocd app diffnocturno).
Onda 2: Observabilidad unificada + Auto-remediación básica (semanas 5-10)
- Desplegar OpenTelemetry Collector (DaemonSet + Deployment) → VictoriaMetrics + Loki + Tempo.
- Dashboards estandarizados (Grafana) por workload type: Spark, Trino, vLLM, Ray, Kafka, Iceberg compaction.
- Reglas de alerta multi-dimensionales (síntoma + impacto + runbook URL) — no umbrales estáticos.
- Primer agente LangGraph + GPT-4o mini (coste bajo) que: recibe alerta → consulta RAG runbooks → propone
kubectl patch/argo rollout retry→ humano aprueba en Slack/Teams. - Métrica objetivo: MTTR < 30 min para alertas P1/P2.
Onda 3: Agentes autónomos completos + AI Platform (semanas 11-24)
- Extender agente a Claude 4 / GPT-4o con MCP completo (K8s, Argo, DataHub, Git, Jira, Confluence).
- Habilitar auto-merge para cambios de bajo riesgo (resource limits, réplicas, configmaps) tras validación en staging.
- Desplegar vLLM Operator + KubeRay para cargas LLM; migrar de APIs externas a modelos abiertos (Llama, Qwen, Nemotron, Mixtral).
- Implementar evaluación continua (RAGAS, DeepEval) como paso de Argo Rollouts antes de promover a prod.
- Métrica objetivo: Lead time for changes < 1 día (DORA elite) en data products; coste inferencia < 30% de gasto cloud total.
Errores frecuentes 2026 (y cómo evitarlos)
- Adoptar Kubernetes sin GitOps → drift y configuraciones heterogéneas. Solución: Argo CD + App of Apps desde el día 1.
- Tratar los modelos LLM como «cajas negras» sin evaluación ni gobernanza → alucinaciones y shadow AI. Solución: RAGAS/DeepEval en CI + DataHub + OpenLineage.
- GPU mal dimensionada → coste disparado. Solución: vLLM + fraccionamiento NVIDIA + autoscaling por cola de requests.
- Automatizar sin human-in-the-loop → cambios riesgosos sin validación. Solución: agentes proponen, humanos aprueban para cambios destructivos.
- Ignorar la capa semántica → agentes sin contexto. Solución: catálogo + data contracts + embeddings versionados.
Conclusión: de Ambari al plano de control autónomo
Ambari nos enseñó el valor de un plano de control único. En 2026-2027, ese plano ya no es un wizard: es una capa de agentes autónomos sobre GitOps, observabilidad e IA que instala, configura, monitoriza y auto-repara la plataforma de datos con trazabilidad completa.
En BAOSS diseñamos e implantamos ese plano de control: Kubernetes multi-cloud, lakehouse abierto, agentes con MCP y gobernanza unificada, con métricas (MTTR, lead time, coste inferencia) y ROI auditado.
¿Quieres dejar de apagar incendios en tu plataforma de datos y pasar a agentes autónomos gobernados? Habla con nuestro equipo de consultoría.