Convertir big data en valor IA agentes y RAG: cómo extraer valor real en 2025
En junio de 2015 publicábamos en este mismo blog que «cualquier negocio que no esté considerando seriamente las implicaciones del Big Data corre el riesgo de quedarse atrás». Sin embargo, diez años después, la frase suena a perogrullo. El problema ya no es capturar datos, porque las empresas se ahogan en ellos. El reto es convertir ese ruido en decisiones rentables antes de que caduquen. Hoy, convertir big data en valor IA agentes es el reto operativo que separa a los líderes del resto.
El panorama 2025-2026 ha cambiado las reglas. El 90% de los datos empresariales son no estructurados (IDC, 2024). Además, el volumen global supera los 181 zettabytes (Statista, 2025). Además, los data lakes tradicionales se han convertido en «data swamps» donde la gobernanza brilla por su ausencia. Mientras, la dirección exige ROI medible en trimestres, no en años.
El problema real 2025: datos sí, inteligencia no
Los CTOs y CDOs con los que hablamos en BAOSS comparten tres dolores comunes:
- Fragmentación extrema: datos en 15-20 sistemas (ERP, CRM, IoT, logs, tickets, documentos, correo, Slack, Confluence, repositorios de código, data warehouses, data lakes, feature stores, vector stores…).
- Brecha semántica: los modelos de lenguaje genéricos (GPT-4o, Claude 4 Sonnet) no entienden el negocio. No conocen tu catálogo, tus SLAs, tu normativa interna ni tu jerga.
- Coste e inercia: entrenar o fine-tunear LLMs propios cuesta 50k-500k€ y 3-6 meses. Para cuando el modelo está listo, los datos ya han cambiado.
La consecuencia es clara. Por consiguiente, solo el 23% de los proyectos de IA generativa pasan de PoC a producción (Gartner, 2024). Además, el resto muere en «purgatorio de pilotos».
Arquitectura 2025: RAG agente, no solo RAG
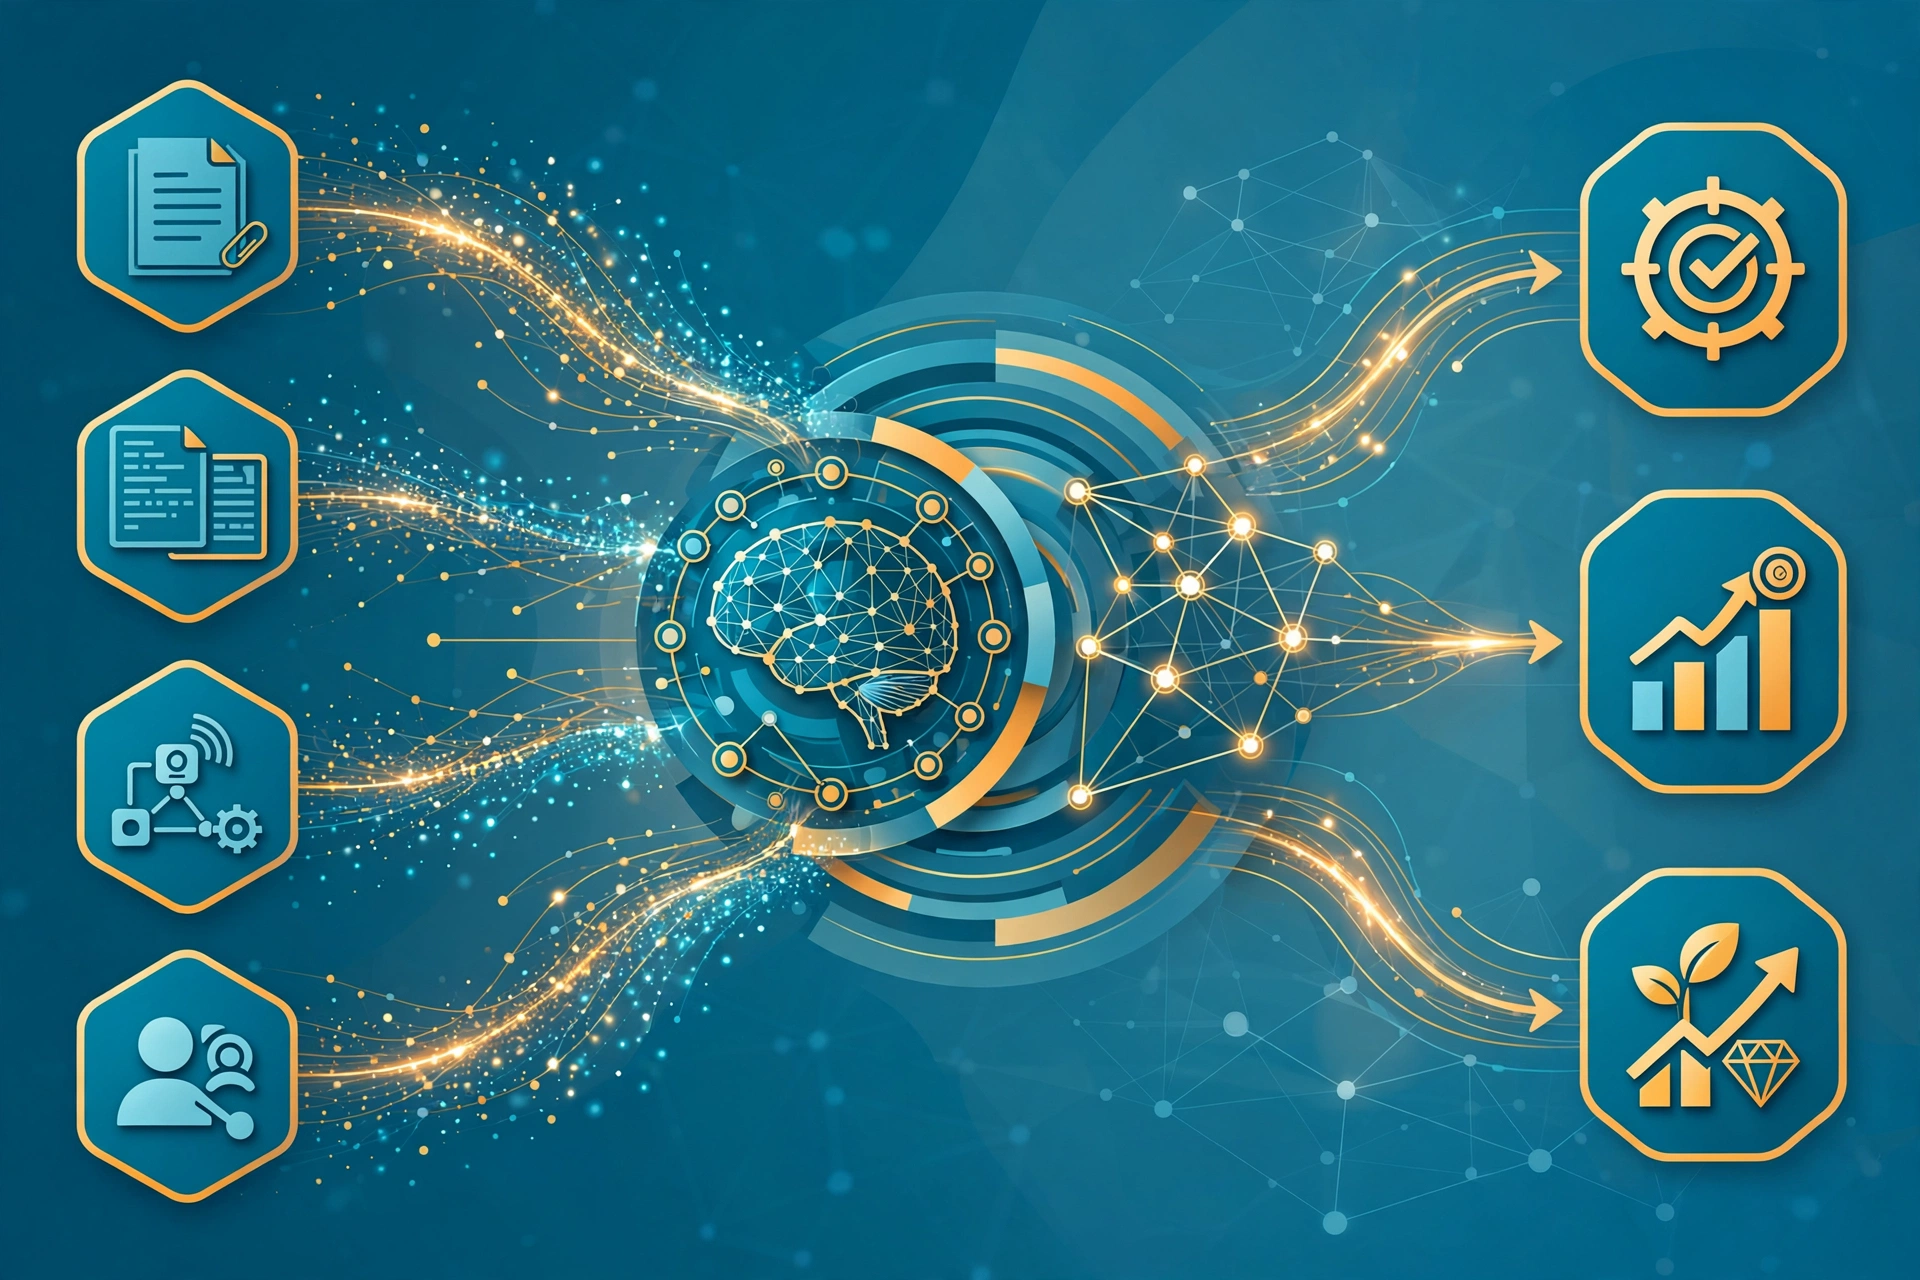
La respuesta no es «más datos» ni «modelos más grandes». Es decir, orquestación inteligente sobre tus datos, con gobernanza nativa. Por eso, en BAOSS desplegamos una pila estandarizada que reduce time-to-value de 6-12 meses a 6-10 semanas:
- Ingesta unificada: conectores CDC (Debezium, Airbyte) + parsers multimodales (Unstructured.io, LlamaParse) para PDFs, audio, vídeo, código, tickets.
- Capa semántica (Knowledge Graph + Vector Store): Neo4j / FalkorDB + Qdrant / Weaviate / Milvus. Entidades, relaciones y embeddings conviven; el grafo aporta trazabilidad, el vector búsqueda semántica.
- RAG agente con tool use: LangGraph / CrewAI / AutoGen orquestan agentes que deciden qué buscar, dónde (SQL, vector, grafo, API externa), cómo validar y cuándo escalar a humano.
- Modelos locales y híbridos: vLLM / Ollama sirven Llama 3.1 70B, Nemotron 3 Ultra o Qwen 2.5 72B en GPU propia (H100, A100, L40S) para datos sensibles; GPT-4o / Claude 4 via API para tareas de razonamiento complejo sin PII.
- Evaluación continua (eval-driven development): RAGAS, DeepEval, patrones LLM-as-a-judge en CI/CD. Métricas: faithfulness, answer relevance, context precision, latency p95 < 2.5s.
- Observabilidad y guardrails: Langfuse / Helicone / Arize Phoenix + NeMo Guardrails / Lakera. Trazas completas, detección de PII, inyección de prompt, alucinación.
Esta arquitectura no es teórica. De hecho, la tenemos en producción en cuatro clientes enterprise (banca, retail, logística, sector público). El nivel de servicio alcanzado es SLA 99.5% y coste por query < 0,015€.
Caso 1: Banca minorista — Resolución automática de reclamaciones (anonimizado)
Contexto: 1,2M reclamaciones/año entre correo, app, sucursales y call center. El 68% no es estructurado (texto libre, adjuntos, grabaciones). Además, el tiempo medio de resolución es de 14 días. El coste unitario: 42€.
Solución BAOSS (8 semanas):
- Pipeline multimodal: Whisper large-v3 (audio) + LlamaParse (PDF/imágenes) → chunks semánticos 512 tokens, overlap 50%.
- Knowledge Graph de productos, normativa (MiFID, GDPR, circulares BdE), jurisprudencia interna y catálogo de respuestas preaprobadas.
- Agente clasificador (LangGraph + Llama 3.1 70B local): tipifica reclamación, extrae entidades (cliente, producto, importe, fechas), detecta urgencia y riesgo legal.
- Agente resolvedor (CrewAI): consulta grafo + vector store, redacta respuesta vinculada a cláusulas exactas, propone resolución (estimación, denegación, escalado).
- Human-in-the-loop: solo el 12% escala a gestor; el 88% se autocompleta con validación «un clic».
Resultados a 6 meses:
- Tiempo medio resolución: 2,3 días (-84%).
- Coste unitario: 6,80€ (-84%).
- NPS reclamaciones: +31 puntos (transparencia, trazabilidad, rapidez).
- ROI: 4,7x (ahorro neto 1,9M€/año vs 405k€ inversión + operación).
Caso 2: Retail omnicanal — Asistente de compra experto para 12M clientes
Contexto: Catálogo 180k SKUs, 450 tiendas, e-commerce, app, marketplace. El cliente medio navega 7 min y abandona el 68% de los carritos. Además, la atención de 1er nivel emplea 4.500 agentes, con AHT 9 min y FCR 61%.
Solución BAOSS (10 semanas):
- Primero, ingesta temps real: PIM, ERP, stock tienda/ecomm, reviews, fichas técnicas, manuales, vídeos demo, tickets históricos (3 años).
- RAG híbrido: vector store (Qdrant, 45M chunks) + grafo (Neo4j, 2,1M nodos: productos, atributos, compatibilidades, sustituciones, promociones).
- Agente conversacional (AutoGen + GPT-4o para razonamiento, Nemotron 3 Ultra local para PII): mantiene contexto multi-turno, accede a APIs temps real (stock, precio, envío), genera comparativas, sugiere alternativas, gestiona devoluciones.
- Evaluación automática nightly: 2.000 queries sintéticas + 500 reales → regression detection en faithfulness, hallucination rate < 0,8%.
Resultados a 4 meses:
- Deflection rate: 41% (chat + voz) vs 18% chatbot anterior.
- AHT agentes humanos: -37% (reciben resumen + acciones propuestas).
- FCR: 82% (+21 pp).
- Conversión asistida: +19% en sesiones con agente IA.
- ROI: 3,2x en 6 meses (ahorro ops + incremental revenue).
Caso 3: Logística — Optimización de última milla con IA explicable
Contexto: 8.500 rutas/día, 120k entregas, 35% ventanas horarias < 2h. Coste km: 1,85€. Penalizaciones SLA: 2,1M€/año. El planificador legado usa reglas estáticas y una reoptimización manual de 4h.
Solución BAOSS (6 semanas):
- Primero, los datos: GPS temps real (1 Hz), tráfico (TomTom + DGT), meteorología (AEMET), histórico entregas (3 años), incidencias, preferencias cliente, restricciones vehículo/conductor.
- Agente planificador (LangGraph + OR-Tools + Llama 3.1 70B): genera plan base con solver VRP-TW. Después, el agente LLM ajusta por contexto «blando» (conductor nuevo, zona obras no mapeada, cliente VIP).
- Explicabilidad nativa: cada decisión (reordenar, insertar, dividir ruta) genera traza en grafo + lenguaje natural para dispatcher.
- Reoptimización continua: evento nuevo (tráfico, incidencia, cancelación) → delta plan < 8 seg.
Resultados a 3 meses:
- Km totales: -12,4% (1,02M km/mes ahorrados).
- Penalizaciones SLA: -67% (690k€/año).
- Tiempo planificación: 4h → 12 min (-95%).
- Adopción dispatchers: 94% (confían porque entienden el «porqué»).
- ROI: 5,1x primer año.
Caso 4: Sector público — Gestión de expedientes complejos con trazabilidad legal
Contexto: 45k expedientes/año (subvenciones, sanciones, licencias). El 78% llega en papel o PDF escaneado. El plazo legal es de 6 meses, pero la media real es de 11 meses. Además, el 32% requiere subsanación (media 2,3 ciclos).
Solución BAOSS (9 semanas, cloud soberano):
- Primero, ingesta masiva: OCR (Tesseract + layoutlmv3) + clasificación documental (BERT fine-tuned) → extracción entidades normalizadas (NIF, CIF, cuentas, fechas, importes, referencias catastrales).
- Knowledge Graph normativo: leyes, reglamentos, jurisprudencia, formularios, plantillas resolución. Versionado temporal (valid-from / valid-to).
- Agente instructor (CrewAI + Llama 3.1 70B local): verifica completitud, detecta inconsistencias, propone subsanaciones redactadas, avisa plazos, genera borrador resolución con citas legales exactas.
- Firma cualificada + registro blockchain (Hyperledger Besu) para inmutabilidad.
Resultados a 5 meses:
- Plazo medio: 11 → 4,2 meses (-62%).
- Subsanaciones: -71% (ciclos 2,3 → 0,7).
- Carga instructor: -58% (foco en casos complejos).
- Recursos judiciales: -43% (calidad jurídica homogénea).
- Coste expediente: -49%.
Lecciones aprendidas: qué separa producción de PoC
- Eval-driven desde día 1: sin dataset de evaluación representativo (mín 500 queries, 50 edge cases), no hay go/no-go objetivo.
- Governance by design: lineage datos → chunk → embedding → respuesta. Auditoría completa para regulador (AI Act, EBA, CNMV). Véase nuestra lección sobre gobernanza de agentes de IA (caso Hugging Face).
- Human-in-the-loop no es opcional: diseña la UX de validación antes que el agente. La confianza es adopción, y es la vía práctica para controlar el riesgo de los agentes de IA.
- Coste predecible: vLLM + Ollama en GPU propia (propia o colocation) bate a API en TCO a partir de 15k queries/día.
Pasar de la prueba de concepto a producción no depende del modelo. Depende de la evaluación continua, la gobernanza desde el diseño, la validación humana y un coste predecible. Esas cuatro disciplinas separan los proyectos que se quedan en demo de los que transforman procesos reales. En definitiva, esa disciplina es la que permite convertir big data en valor IA agentes y no en otra demo. Si quieres ver el marco completo, empieza por qué es BAOSS, el sistema operativo para agentes de negocio.
¿Tienes un piloto de IA atascado antes de producción? Sin embargo, en BAOSS lo llevamos hasta el final, con métricas y gobernanza. Hablemos.