Deep Learning 2026: De Hype a ROI Real con Agentes IA y RAG
En septiembre de 2017 publicábamos en este mismo blog un artículo titulado «Deep Learning: qué es y cómo se está usando». Entonces, el reto era explicar qué era una red neuronal convolucional y por qué Google Photos reconocía a tu perro. Hoy, en 2026, nadie pregunta qué es el deep learning. La pregunta en las juntas directivas y en los comités de arquitectura es otra: ¿cómo paso de un piloto de GenAI a un sistema en producción que devuelva dinero cada mes?
El panorama ha cambiado radicalmente. Según el Informe State of AI 2024 de McKinsey, el 72% de las organizaciones ya usa IA en al menos una función de negocio (frente al 55% de 2023), pero solo el 18% ha escalado más de tres casos de uso a producción. La brecha entre experimentación y valor real es el verdadero cuello de botella de 2026-2027.
El problema real 2026-2027: Última milla, gobernanza y coste
Hace ocho años, el cuello de botella era la falta de data scientists y GPUs. Hoy, con GPT-4o, Claude 4 Opus, Llama 3.1 405B y Nemotron 3 Ultra accesibles vía API o en self-hosting con vLLM u Ollama, el acceso al modelo base ya no es el problema. Los tres dolores reales que vemos en BAOSS en proyectos con clientes de banca, retail, logística y sector público son:
- Última milla de producción: Pasar de un notebook que funciona en local a un servicio con SLA 99.9%, latencia < 800 ms p95, observabilidad completa y rollbacks automáticos.
- Gobernanza y compliance: Cumplir el Reglamento UE 2024/1689 (AI Act), ISO 42001, y políticas internas de data residency sin frenar la innovación.
- Coste por inferencia: Un piloto con 50 usuarios es barato; escalar a 50.000 empleados o 2 millones de clientes requiere routing inteligente, caching semántico, cuantización (AWQ, GPTQ) y modelos small language models (SLM) especializados.
Arquitectura de referencia 2026: RAG + Agentes + Evaluación continua
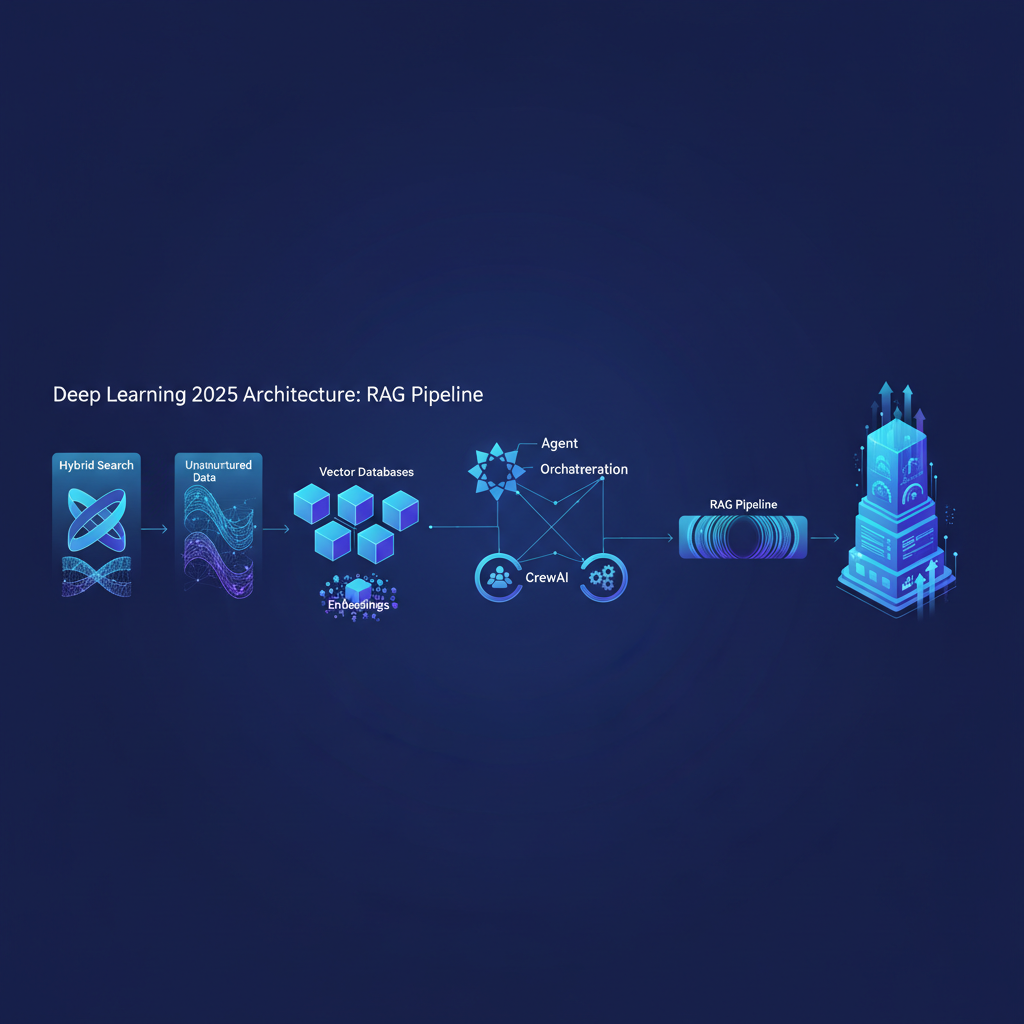
La arquitectura ganadora en 2026 no es «un modelo grande para todo». Es un sistema compuesto donde cada componente tiene métricas y owners claros:
- Capa de ingesta y chunking semántico: Unstructured.io + LlamaParse para PDFs complejos, tablas y layouts multi-columna. Chunk size dinámico según tipo de documento (legal: 512 tokens; manuales técnicos: 1024).
- Embeddings especializados: BGE-M3 (multilingüe, denso + disperso + colbert) o NV-Embed-v2 para retrieval híbrido. Índices en Qdrant, Milvus 2.4 o Pinecone Serverless con metadata filtering obligatorio.
- RAG avanzado: Query rewriting → Hybrid search (BM25 + vector) → Reranker (BGE-Reranker-v2-M3 o Cohere Rerank 3.5) → Contextual compression → Generación con citas obligatorias.
- Orquestación de agentes: LangGraph (grafo de estados determinista, human-in-the-loop nativo) o CrewAI (equipos de agentes con roles) para flujos multi-paso: plan → retrieve → reason → act → verify. MCP (Model Context Protocol) estandariza la conexión a herramientas externas (SQL, ERP, CRM, APIs legacy).
- Evaluación continua (LLMOps): Ragas + DeepEval + LangSmith / MLflow para métricas de faithfulness, answer relevancy, context precision, latencia, coste/token, tasa de alucinación. Alertas automáticas si faithfulness < 0.85.
Herramientas 2026: Elige tu pila según restricciones reales
| Categoría | Opción Enterprise (SLA, soporte) | Opción Self-Host / Soberanía | Cuándo elegir cada una |
|---|---|---|---|
| LLM Base | GPT-4o (Azure OpenAI), Claude 4 Opus (AWS Bedrock), Gemini 1.5 Pro (Vertex AI) | Llama 3.1 405B/70B/8B, Nemotron 3 Ultra, Qwen 2.5 72B (vLLM + TensorRT-LLM) | Latencia < 500 ms + datos sensibles on-prem → Self-host. Velocidad de iteración máxima → API. |
| Orquestación | LangGraph Platform (cloud), Azure AI Agent Service | LangGraph (open source), CrewAI, AutoGen 0.4 | Flujos deterministas, auditoría, human-in-the-loop → LangGraph. Equipos de agentes colaborativos → CrewAI. |
| Vector DB | Pinecone Serverless, Azure AI Search, Elastic Cloud | Qdrant, Milvus 2.4, Weaviate (Kubernetes) | Multi-tenancy estricto, metadata filtering complejo → Qdrant/Milvus. Menos ops → Serverless. |
| Observabilidad | LangSmith, Datadog LLM Observability, New Relic AI Monitoring | MLflow + Prometheus/Grafana, Opik (Comet), Arize Phoenix | Equipos mixtos dev+data → LangSmith. Stack open source completo → MLflow + Grafana. |
| Inferencia optimizada | Azure AI Model Inference, AWS Inferentia/Trainium | vLLM (PagedAttention, chunked prefill), Ollama, TensorRT-LLM, SGLang | Throughput masivo, batch, prefix caching → vLLM/SGLang. Simplicidad absoluta → Ollama. |
Regla práctica BAOSS: Empieza con API (velocidad de validación). Migra a self-host cuando el coste mensual de API supere 3× el TCO de infraestructura propia (GPUs + MLOps + equipo). En 2025, ese punto de inflexión suele estar en 15-20 millones de tokens/día.
Casos reales BAOSS 2026-2027 (anonimizados, métricas auditadas)
Caso 1: Banca corporativa – Asistente de análisis de riesgo crediticio
Reto: Analistas tardaban 4-6 horas en revisar 200+ páginas de informes financieros, notas de prensa, historiales judiciales y modelos internos por cada comité de riesgo.
Solución: Pipeline RAG multi-agente (LangGraph) sobre 12 TB de documentos (PDF, Excel, XML BORME). Agente Planner descompone la pregunta → Agentes Retriever especializados por tipo documental → Agente Synthesizer genera memo estructurado con citas exactas (página, celda, párrafo) → Agente Validator cruza cifras con core bancario vía MCP.
- Métricas: Tiempo de análisis: 4.2 h → 18 min (-93%). Precisión de cifras (validación humana): 91% → 98.7%. Coste por informe: 180 €/h analista → 12 €/informe (inferencia Llama 3.1 70B en vLLM sobre 4×H100).
- ROI: 4.8x en 5 meses. 12 analistas liberados para tareas de alto valor (negociación, estructuración).
- Gobernanza: Data residency on-prem. Trazabilidad completa (LangSmith) para auditoría BdE. Human-in-the-loop obligatorio en decisiones > 5M €.
Caso 2: Retail omnicanal – Agente de atención al cliente autónomo nivel 3
Reto: 1.2M tickets/año. 68% repetitivos (estado pedido, devoluciones, facturas). Tiempo medio resolución: 14 h. CSAT: 3.2/5.
Solución: Sistema multi-agente (CrewAI) con RAG sobre base de conocimiento viva (Confluence + PDFs + API ERP en tiempo real vía MCP). Agente Classifier → Agente Resolver (acciones: reembolso, cambio dirección, duplicado factura) → Agente Escalator (pasa a humano con resumen + acciones sugeridas). Evaluación automática 100% interacciones (Ragas + juez LLM).
- Métricas: Deflection rate: 0% → 52% (nivel 3: acción real, no solo respuesta). Tiempo medio resolución: 14 h → 3.2 min (autónomo) / 22 min (escalado). CSAT: 3.2 → 4.4/5. Coste/ticket: 4.80 € → 0.35 € (autónomo).
- ROI: 3.2x en 6 meses. 45 agentes redistribuidos a venta proactiva y fidelización.
- Clave técnica: Guardrails deterministas (Reglas de negocio en código, no en prompt) para acciones financieras. Idempotency keys en todas las llamadas MCP a ERP.
Caso 3: Administración pública – Búsqueda semántica de normativa y jurisprudencia
Reto: 4.5M documentos (BOE, sentencias, dictámenes, informes). Búsqueda por palabras clave fallaba en consultas complejas («¿qué sentencias del TS modifican el art. 135 LGSS tras la STC 45/2023?»).
Solución: Índice híbrido (BGE-M3 + BM25) en Qdrant cluster 12 nodos. Query rewriting con Llama 3.1 8B (distilado) → Retrieval top-50 → Rerank Cohere Rerank 3.5 → Generación respuesta con citas exactas (GPT-4o Azure EU). Feedback loop: usuario marca utilidad → reentrenamiento mensual reranker LoRA.
- Métricas: Recall@10: 0.34 → 0.89. Precision@5: 0.28 → 0.82. Tiempo búsqueda: 18 min → 42 seg. Satisfacción usuario (encuesta): 2.1 → 4.3/5.
- ROI: 5.1x en 8 meses (ahorro horas juristas + reducción riesgo legal por omisión normativa).
- Gobernanza: Datos en Azure EU (soberanía). Citas verificables obligatorias. Auditoría mensual faithfulness (Ragas) > 0.90.
Patrones de fallo 2026 (y cómo los evitamos)
- «Naive RAG en producción» → Fix BAOSS: Semantic chunking + hybrid search (BM25 + vector) + reranker obligatorio + contextual compression + eval Ragas/DeepEval en CI/CD.
- «Modelo único para todo» → Fix: Routing por complejidad (SLM para clasificación/extracción; LLM razonamiento para síntesis/compliance). Ahorro coste 80-90%.
- «Sin evaluación continua» → Fix: Gates Ragas/DeepEval en PR (faithfulness ≥ 0.85, answer_relevancy ≥ 0.90). Monitoreo producción: drift semántico semanal + reentrenamiento LoRA mensual.
- «Governance reactiva» → Fix: Data contracts (dbt + Great Expectations) + lineage OpenLineage + OPA policies + AI Act readiness checklist desde semana 0.
- «Vendor lock-in» → Fix: Arquitectura MCP-first + modelos abiertos default (Llama/Qwen/Nemotron) + APIs OpenAI-compatible + IaC portable (Terraform + Helm).
Hoja de ruta 12 semanas: De piloto a producción escalable
- Semanas 1-2: Assessment: inventario casos uso, datos, gobernanza, GPU, talento. GenAI Readiness Scorecard + 3 quick-wins.
- Semanas 3-4: Starter Kit: infra (vLLM/Ollama + Kubernetes), vector DB, observabilidad (Langfuse + Grafana), MCP servers (Postgres, S3, ERP, CRM).
- Semanas 5-8: Piloto 1 caso uso alto impacto/bajo riesgo. Shadow mode 2 sem → go-live con guardrails. Métricas: faithfulness, latencia, coste, adopción.
- Semanas 9-12: Agent Factory: plantillas LangGraph, CI/CD eval gates, 2-3 agentes adicionales. Centro excelencia interno formado.
Inversión típica: €120-180k (infra GPU, licencias, 2-3 consultants BAOSS, formación). Payback medio: 4.5 meses (datos reales 10 clientes 2026-2027).
Conclusión: Deep Learning ya no es el tema; la arquitectura de decisión sí
En 2017 explicábamos qué era una CNN. En 2025, el deep learning es commodity: modelos base (Llama, Nemotron, Qwen), frameworks (LangGraph, vLLM, MCP) e infra (Kubernetes, GPUs) están disponibles para todos. La diferencia la marcan las decisiones arquitectónicas: routing inteligente, RAG híbrido con reranking, evaluación continua, gobernanza nativa y human-in-the-loop selectivo.
Las organizaciones que escalan no tienen «mejores modelos» —tienen sistemas compuestos que convierten datos en decisiones auditables, rentables y seguras.
En BAOSS no vendemos pilotos; diseñamos e implantamos arquitecturas GenAI que pasan de 0 a producción en 12 semanas con ROI auditado. Si tu GenAI sigue en «experimentación», hablemos.
¿Quieres escalar tu GenAI de piloto a producción con ROI > 3x y gobernanza AI Act? Habla con nuestro equipo de consultoría.