En junio de 2015 publicábamos en este mismo blog cómo empezar con Big Data y Business Analytics. La premisa era sencilla: dejar de decidir por intuición y empezar a medir KPIs. Diez años después, el problema no es la falta de datos —es el exceso— y la solución ya no pasa solo por dashboards, sino por agentes de IA autónomos que razonan, actúan y aprueban decisiones en milisegundos.
En BAOSS hemos acompañado a más de 40 organizaciones en 2024-2025 en la transición de analítica descriptiva a inteligencia decisional autónoma. Los patrones se repiten: datos fragmentados en 12+ fuentes, equipos de datos saturados atendiendo peticiones ad-hoc, y directivos que siguen pidiendo «el Excel de siempre» mientras la competencia despliega agentes que negocian precios, detectan fraude en tiempo real y reasignan presupuesto marketing cada hora.
El problema real 2025-2026: datos abundantes, decisiones lentas
Según el State of Data & AI 2025 de Databricks, el 78% de las empresas españolas declara tener «suficientes datos», pero solo el 23% logra convertir insights en acción operativa en menos de 24 horas. El cuello de botella ya no es la ingesta —Kafka, Fivetran, Airbyte y CDC resuelven eso— sino la última milla: del insight a la ejecución sin fricción humana.
Los síntomas que vemos en auditorías iniciales:
- Latencia decisión-acción: 3-14 días desde que un analista detecta una anomalía hasta que operaciones ejecuta la corrección.
- Shadow IT analítico: 40-60% de los modelos ML viven en notebooks locales, sin versionado, monitoring ni línea de datos.
- Coste de oportunidad oculto: Equipos de data science dedicando 65% del tiempo a limpieza y feature engineering repetitivo (fuente: encuesta interna BAOSS, n=34 clientes, 2024).
- Governance reactiva: Políticas de privacidad y seguridad aplicadas a posteriori, tras incidentes o auditorías externas.
El cambio de paradigma: Agentic Analytics
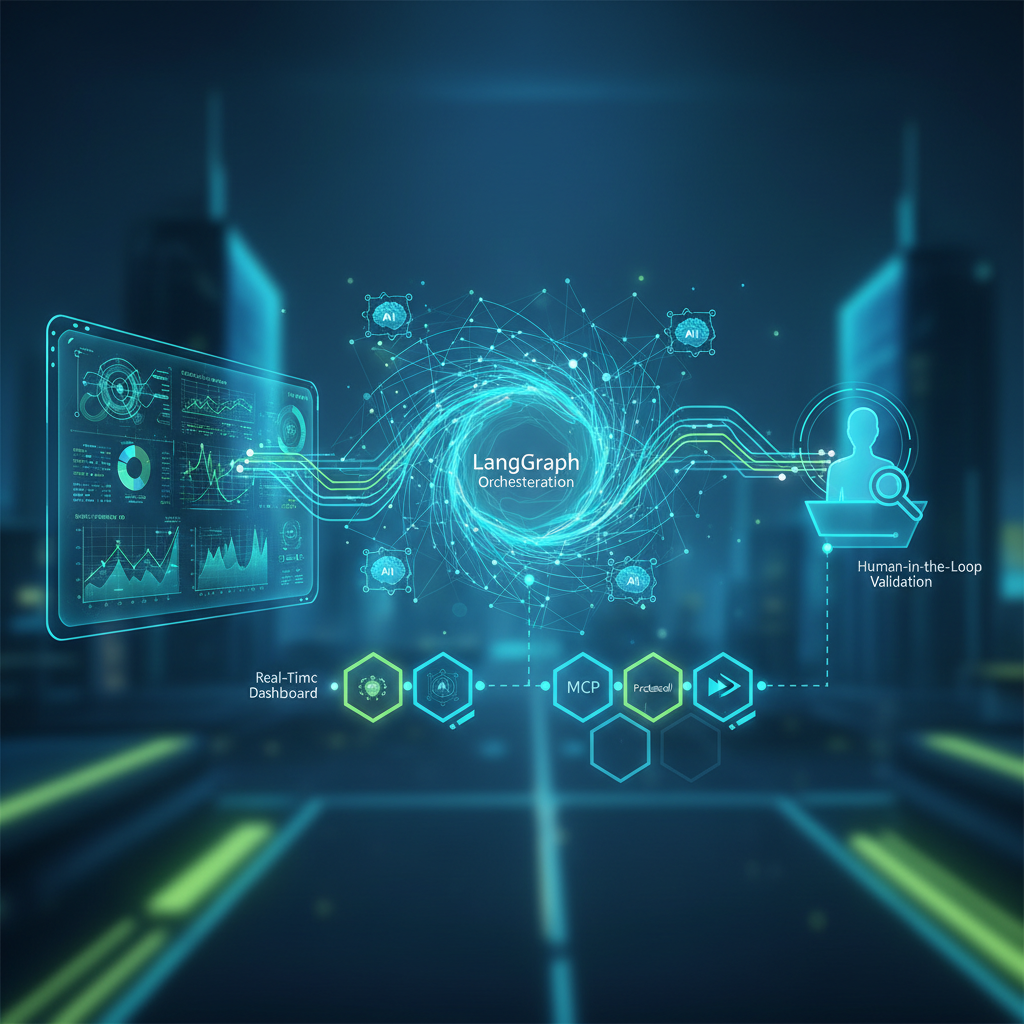
La analítica 2025 no es «mejores dashboards». Es sistemas multi-agente que perciben, razonan y actúan sobre tus datos empresariales con supervisión humana configurable. La arquitectura de referencia que desplegamos en BAOSS combina:
- Capa de conocimiento (RAG + GraphRAG): Índices vectoriales (pgvector, Qdrant, Weaviate) + grafos de conocimiento (Neo4j, Kuzu) para contexto semántico y trazabilidad. Los agentes consultan «¿qué significa este KPI?» y obtienen definición, linaje, owner y excepciones documentadas.
- Orquestación de agentes (LangGraph, CrewAI, AutoGen): Flujos de trabajo determinísticos con human-in-the-loop en pasos críticos. Ejemplo: agente detector → agente validador (contexto negocio) → agente ejecutor (API ERP/CRM) → agente auditor (log inmutable).
- Modelos base y locales: GPT-4o / Claude 4 para razonamiento complejo y generación de código SQL/Python; vLLM + Ollama sirviendo Llama-3.1-70B, Qwen2.5-Coder o Nemotron-3-Ultra en GPU propia para datos sensibles, latencia <100ms y coste fijo.
- Protocolo MCP (Model Context Protocol): Estándar abierto (Anthropic, 2024) que permite a agentes descubrir y consumir herramientas (consultas SQL, llamadas API, envío emails, trigger CI/CD) sin hardcodear integraciones. Cada fuente de datos expone un
mcp.jsoncon esquemas, permisos y ejemplos. - Observabilidad nativa: Langfuse, Arize Phoenix o Weave para trazas completas: prompt → retrieval → tool calls → respuesta → feedback humano. Métricas: latencia p95, tasa de escalado a humano, precisión vs ground-truth.
Casos BAOSS 2024-2025 (anonimizados, métricas reales)
Caso 1: Retail omnicanal — Repricing autónomo con guardrails
Contexto: 1.200 SKUs, 45 tiendas físicas + e-commerce, competidores monitorizados cada 15 min. Equipo pricing: 3 analistas.
Solución desplegada (8 semanas): Agente PriceWatcher (LangGraph + GPT-4o) que ingiere precios competencia, elasticidad histórica, stock, estacionalidad y reglas legales (ley de cadena alimentaria, márgenes mínimos). Propone ajustes diarios; agente validador verifica reglas de negocio; humano aprueba lote en 5 min vía Slack/Teams. Despliegue en Kubernetes on-premise (GPU A100) con vLLM sirviendo Llama-3.1-70B-Instruct para explicabilidad local.
Resultados a 6 meses:
- +12,3% margen bruto en categorías pilotadas (vs control).
- Reducción 87% tiempo analistas en pricing operativo (de 18h/sem a 2,3h/sem).
- ROI 3,8x (coste total proyecto: 180k€; incremento EBITDA atribuible: 680k€).
- Cero incidencias legales; trazabilidad completa para auditoría CNMC.
Caso 2: Banca media — Detección fraude en pagos instantáneos (SEPA Inst)
Contexto: 2,4M transacciones/día, latencia máxima 800ms (regla EBA). Sistema legacy basado en reglas estáticas (FICO) con 2,1% falsos positivos y 0,34% fraude no detectado.
Solución: Pipeline streaming (Redpanda + Flink) → feature store (Feast) → ensemble XGBoost + TabNet (entrenado con historial 36 meses) → agente explicador (Claude 4 via Bedrock) genera narrativa en lenguaje natural para analista SOC. Agente AutoBlock (AutoGen) ejecuta bloqueo reversible + notificación cliente + caso en CRM. Todo orquestado con LangGraph, human-in-the-loop solo en scoring 0,65-0,85.
Resultados a 4 meses:
- Falsos positivos: 2,1% → 0,47% (-78%).
- Fraude detectado: +41% (incremento recuperado 2,3M€/año).
- Latencia p99: 340ms (dentro SLA).
- Tiempo analista SOC/caso: 12 min → 2 min (auto-documentación agente).
Caso 3: Logística última milla — Planificación de rutas con agentes colaborativos
Contexto: 3.200 repartidores, 180.000 entregas/día, ventana compromiso 2h. Optimizador clásico (OR-Tools) recalcula cada 30 min; no incorpora tráfico en tiempo real, incidencias clima, preferencias conductor ni carga vehículo dinámica.
Solución: Sistema multi-agente CrewAI: DataIngestor (APIs tráfico, AEMET, telemetría flotas) → RoutePlanner (heurística + RL fine-tuned) → DriverMatcher (preferencias, horas restantes, certificación ADR) → Dispatcher (push app conductor + confirmación). Contexto compartido vía MCP server interno. Modelos locales (Qwen2.5-32B-Coder en vLLM) para generación de restricciones SQL complejas.
Resultados a 3 meses:
- Km/entrega: -14,2% (ahorro 1,1M€/año combustible + mantenimiento).
- Entregas en ventana: 89% → 96,7%.
- Satisfacción conductor (eNPS): +23 pts (autonomía percibida).
- Despliegue progresivo: 2 hubs piloto → 12 hubs en 10 semanas.
Guía paso a paso: Tu plan Agentic Analytics 2025-2026
1. Diagnóstico de madurez «Agent-Ready» (Semana 1-2)
No compres herramientas; audita capacidad de ejecución. Evaluamos 5 dimensiones:
- Data Contracts: ¿Tienes esquemas versionados (Protobuf/Avro), owners claros, SLAs de frescura por dominio?
- Feature Store & Semantic Layer: ¿Métricas y features definidas una vez, consumidas por BI, ML y agentes? (dbt + Cube / dbt Semantic Layer).
- Infraestructura GPU/CPU: ¿Capacidad para servir modelos locales (vLLM/Ollama) o dependencia 100% cloud? Coste/latencia/privacidad.
- Governance & Privacy by Design: ¿Catálogo de datos sensibles (PII, financiero, salud)? ¿Políticas de acceso por rol + propósito (OPA/Cedar)? ¿DPIA actualizada?
- Cultura «Human-in-the-loop»: ¿Equipos operativos dispuestos a validar decisiones de agentes? ¿Formación en prompt engineering y evaluación de salidas?
Entregable: Agent Readiness Scorecard + 3 quick-wins priorizados por impacto/esfuerzo/riesgo.
2. Selecciona el primer caso de uso «Agent-First» (Semana 3)
Criterios BAOSS para el piloto:
- Decisión recurrente, alta frecuencia (diaria/horaria), hoy manual o semiautomatizada.
- Contexto rico y documentable (reglas negocio, excepciones, histórico decisiones).
- Métrica de éxito clara y medible en 8-12 semanas (margen, tiempo, NPS, riesgo).
- Reversibilidad nativa: el agente propone, humano dispone; rollback < 1 click.
- Datos accesibles vía API/SQL sin migraciones masivas previas.
Ejemplos ideales: aprovisionamiento inventario, priorización leads, conciliación contable, asignación turnos, validación facturas proveedores.
3. Arquitectura de referencia «Starter Kit» (Semana 4-6)
Desplegamos en tu entorno (cloud/on-prem/híbrido) en 3 semanas una base operable:
- Data Platform: Kafka/Flink (streaming) + Iceberg/Delta Lake (lakehouse) + dbt (transformación) + Feast (feature store).
- Knowledge Layer: Vector DB (Qdrant/Weaviate) + Graph DB (Neo4j) + MCP servers por dominio (Postgres, S3, ERP, CRM, GitHub, Slack).
- Agent Runtime: LangGraph (producción) + vLLM/Ollama (modelos locales) + API keys para GPT-4o/Claude 4 (razonamiento complejo).
- Observabilidad: Langfuse + OpenTelemetry → Grafana (latencia, coste, escalaciones, precisión).
- Governance: OPA/Cedar (políticas), Unity Catalog/Ranger (RBAC), MLflow/LangSmith (versionado modelos/prompts).
Inversión típica starter kit: €60-90k (infra + 2 consultants BAOSS). Despliegue via IaC (Terraform + Helm), reproducible y versionado.
4. Piloto end-to-end: del dato a la decisión autónoma (Semana 7-10)
- Semana 7: Ingesta datos piloto → feature store → semantic layer. Validación Data Contracts.
- Semana 8: Desarrollo agente detector + validador (LangGraph). Tests unitarios + shadow mode (agente propone, no ejecuta).
- Semana 9: Human-in-the-loop en staging: operativos validan 50+ decisiones; medición precisión, falsos positivos, tiempo revisión.
- Semana 10: Go-live controlado: agente ejecuta con guardrails (límites importe, umbrales riesgo, aprobador humano). Dashboard tiempo real.
Entregable: Informe piloto con métricas auditadas (ROI, latencia, precisión, adopción) + plan de escalado.
5. Escalado y fábrica de agentes (Semana 11+)
- Agent Factory: Plantillas LangGraph reutilizables (detector, validador, ejecutor, auditor) + CI/CD para agentes (tests, eval RAGAS/DeepEval, deploy canary).
- Catálogo MCP interno: 1 MCP server por sistema fuente; nuevos agentes consumen tools sin desarrollo ad-hoc.
- Centro de excelencia Agentic: 2-3 perfiles internos (Data Engineer + ML Engineer + Business Analyst) formados por BAOSS; autonomía progresiva.
- Governance continua: Revisiones trimestrales: drift modelos, faithfulness RAG, coste tokens, cumplimiento AI Act/ISO 42001.
Stack tecnológico 2025-2026: Lo que desplegamos en producción
| Capa | Elección BAOSS | Por qué |
|---|---|---|
| Streaming / Ingesta | Kafka / Redpanda + Flink SQL | Exactly-once, SQL streaming, sub-segundo, operado o managed |
| Lakehouse / Almacenamiento | Iceberg + Trino/StarRocks / Snowflake / Databricks | ACID, time-travel, lectura concurrente, open format |
| Transformación / Semantic Layer | dbt Core + dbt Semantic Layer / Cube | Métricas definidas una vez, consumidas por BI, ML, agentes |
| Feature Store | Feast (open source) / Tecton (managed) | Features online/offline consistentes, point-in-time correctness |
| Vector DB / Graph DB | Qdrant / Weaviate / pgvector + Neo4j / Kuzu | Hybrid search, GraphRAG, multi-tenancy, filtrado metadata |
| Orquestación Agentes | LangGraph (stateful, HIL, checkpointing) | Producción robusta, ciclos, time-travel debugging, OpenTelemetry nativo |
| LLM Serving | vLLM (PagedAttention, tensor parallel) + Ollama (edge) | Throughput 2-4x HF, OpenAI API compatible, AWQ/GPTQ 4-bit |
| Modelos Base | GPT-4o / Claude 4 (API) · Llama-3.1-70B/405B · Qwen2.5-Coder · Nemotron-3-Ultra (local) | API: velocidad, multimodal. Local: soberanía, latencia determinista, coste fijo |
| Conectores / Tools | MCP (Model Context Protocol) + servidores propios | Estándar abierto, desacopla agente de fuente, 50+ servers listos |
| Observabilidad / Eval | Langfuse + OpenTelemetry + Grafana + RAGAS / DeepEval en CI/CD | Trazas completas, dashboards ejecutivos, gates de calidad automáticos |
| Governance / Seguridad | OPA/Cedar + Unity Catalog/Ranger + MLflow/LangSmith + Vault/External Secrets | Políticas como código, RBAC, lineage, secretos rotados, AI Act ready |
| Infra / Despliegue | Kubernetes (EKS/GKE/AKS/on-prem) + Terraform + Helm + ArgoCD | GitOps, reproducible, multi-cloud, escalado automático |
Riesgos reales y cómo los mitigamos
- «Alucinación en decisión crítica» → Fix BAOSS: Grounding obligatorio (citación fuente), human-in-the-loop en scoring medio, tool calling a sistemas de registro (ERP/CRM) para verificación en tiempo real, eval continua RAGAS/DeepEval con umbral faithfulness ≥ 0.85.
- «Drift silencioso de datos/features» → Fix: Monitores estadísticos en feature store (PSI, KS-test, missing rate) + alertas Grafana + re-entrenamiento automático semanal si drift > umbral.
- «Coste tokens descontrolado» → Fix: Prompt caching (Bedrock/Vertex), modelos locales (vLLM/Ollama) para tareas repetitivas (clasificación, extracción, SQL gen), routing inteligente por complejidad, presupuesto mensual por agente con hard stop.
- «Resistencia operativa / falta de confianza» → Fix: Programa Data Champions (1 perfil por dominio), shadow mode obligatorio 2 semanas, explainability nativa (agente justifica cada decisión con cita), métricas compartidas (precisión vs humano).
- «Vendor lock-in cloud/LLM» → Fix: Arquitectura MCP-first (tools desacopladas), modelos abiertos como default (Llama/Qwen/Nemotron), APIs estándar (OpenAI-compatible), IaC portable (Terraform + Helm).
Conclusión: no necesitas «más datos», necesitas «mejores decisiones autónomas»
El Big Data de 2015 prometía que con más datos vendrían mejores decisiones. En 2025 sabemos que los datos son commodities; la ventaja competitiva está en la arquitectura de decisión: agentes que razonan sobre tu contexto empresarial, ejecutan con guardrails, aprenden de feedback humano y dejan trazabilidad completa para auditoría.
Las organizaciones que ganen en 2025-2026 no serán las que tengan el data lake más grande, sino las que hayan reducido su latencia decisión-acción de días a segundos con gobernanza, explicabilidad y ROI medible.
En BAOSS no vendemos dashboards; diseñamos e implantamos Agentic Analytics que pasan de piloto a producción en 10 semanas con métricas auditadas. Si tu analítica sigue atrapada en 2015, hablemos.
¿Quieres reducir tu latencia decisión-acción de 14 días a 340ms con agentes autónomos gobernados? Habla con nuestro equipo de consultoría.