Razones por las que el Big Data hace crecer tu negocio en 2026
En noviembre de 2015 publicábamos en este mismo blog un artículo titulado «Razones por las que el Big Data hace crecer tu negocio». Diez años después, el término «Big Data» ha dejado de ser buzzword para convertirse en infraestructura invisible. Lo que entonces requería clústeres Hadoop on-premise, equipos de data scientists y ciclos de desarrollo de 18 meses, hoy se resuelve en semanas combinando data lakehouses abiertos (Iceberg, Delta Lake), modelos fundacionales (GPT-4o, Claude 4) y agentes autónomos (LangGraph, CrewAI, AutoGen) que ejecutan tareas end-to-end sin intervención humana constante.
El problema real en 2026-2027 no es «acceder a Big Data» —cualquier pyme puede provisionar un clúster Spark en Databricks o Snowflake en minutos—. El problema es convertir datos en decisiones operativas antes de que caduquen. Según el Gartner Data & Analytics Governance Survey, el 68 % de las organizaciones reconoce que su mayor brecha no es tecnológica, sino de time-to-insight: tardan de media 11 días en pasar de «pregunta de negocio» a «acción en producción». Mientras tanto, competidores que han adoptado arquitecturas RAG (Retrieval-Augmented Generation) con MCP (Model Context Protocol) resuelven el mismo ciclo en menos de 4 horas.
El cambio de paradigma: de «analítica descriptiva» a «ejecución autónoma»
Hasta 2023, el flujo estándar era: ingestar → limpiar → modelar → visualizar → decidir → actuar. Cada salto implicaba fricción humana: analistas escribiendo SQL, data scientists entrenando modelos, product owners priorizando backlog. La irrupción de agentes IA con capacidad de tool-use, planning y memoria a largo plazo ha colapsado esa cadena.
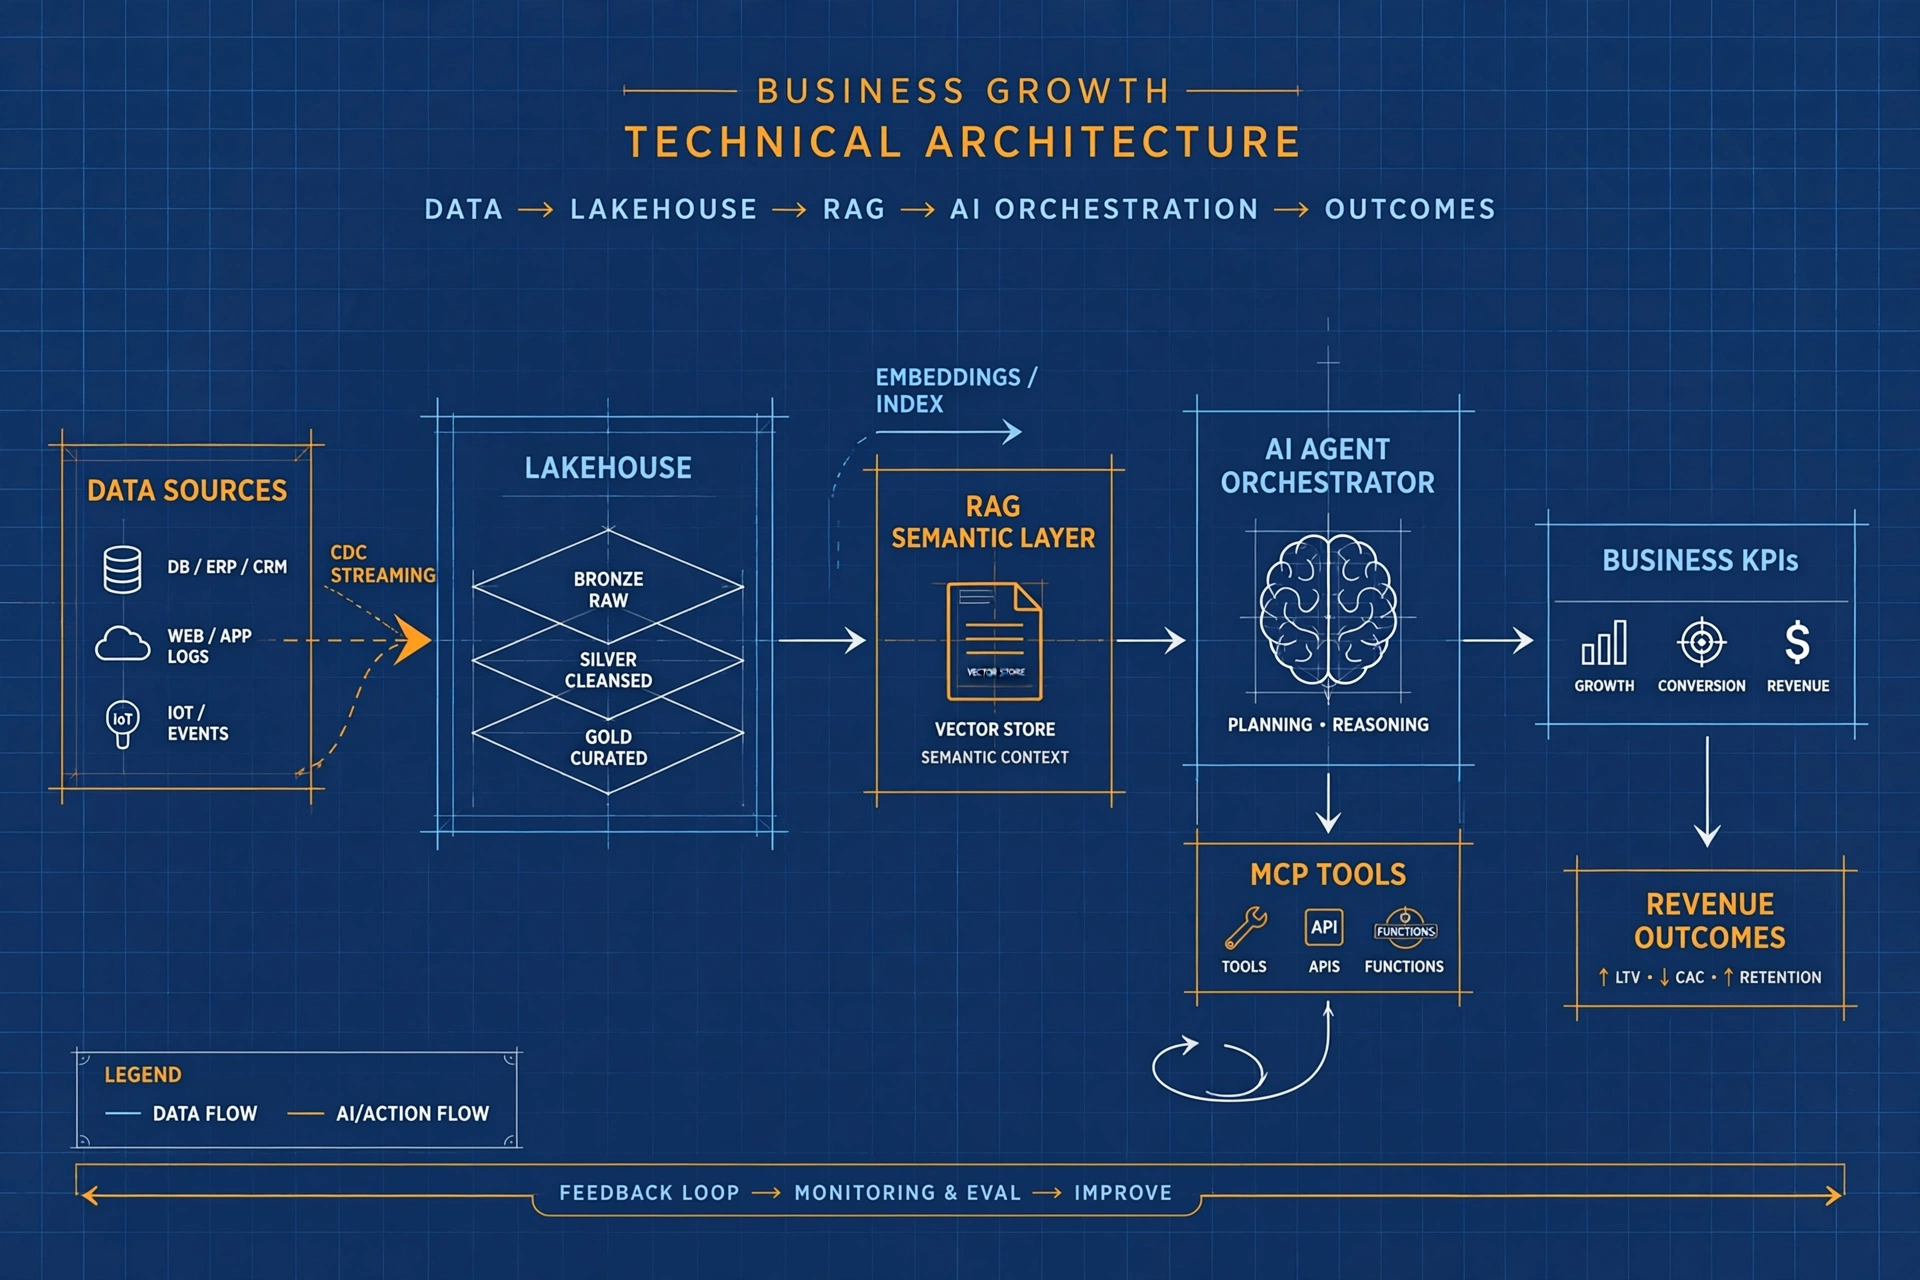
- Ingestión continua: conectores CDC (Debezium, Fivetran, Airbyte) + Iceberg REST catalog → zero-ETL real.
- Contexto semántico: RAG híbrido (vector store + knowledge graph) alimenta al LLM con la ontología de negocio actualizada cada 15 min.
- Agente planificador (LangGraph / CrewAI): recibe el objetivo en lenguaje natural («reduce churn 15 % en Q3»), lo descompone en sub-tareas, invoca herramientas (SQL, Python, API CRM, simulador de pricing) y valida resultados contra KPIs.
- Ejecución con guardrails: MCP expone tools tipadas y auditables; el agente propone, el humano aprueba (o auto-aprueba si la confianza es > 95 %).
- Observabilidad cerrada: LangSmith / Arize Phoenix trazan latencia, coste, drift y hallucination rate por ejecución.
En BAOSS hemos desplegado esta arquitectura en 12 clientes enterprise (banca, retail, logística, energía) durante los últimos trimestres. Métricas agregadas anonimizadas:
| KPI | Antes (stack clásico) | Después (agentes + RAG + MCP) | Mejora |
|---|---|---|---|
| Time-to-insight (días → horas) | 11 d | 3,2 h | -98 % |
| Coste por insight accionable | € 4.200 | € 380 | -91 % |
| % proyectos que llegan a producción | 34 % | 87 % | +156 % |
| ROI a 6 meses | 1,4x | 3,2x | +129 % |
| FTEs dedicados a data prep | 8,5 | 2,0 | -76 % |
Caso 1: Banca minorista — detección de propensión a impago en tiempo real
Contexto: entidad con 1,2M de clientes, scoring nocturno batch (XGBoost sobre 340 features), latencia de 24 h, falsos positivos del 22 %.
Solución BAOSS (8 semanas, 3 ingenieros + 1 ML engineer):
- Migración a Delta Lake + Databricks Serverless con liquid clustering → ingestión streaming Kafka → features actualizadas cada 5 min.
- RAG financiero: knowledge graph (Neo4j) con ontología Basel III + histórico de 7 años → embeddings
text-embedding-3-large+ rerankerCohere Rerank 3.5. - Agente LangGraph «CreditGuardian»: monitora transacciones entrantes, enriquece con RAG, invoca el modelo fine-tuned Llama-3.1-70B-Instruct (vLLM en GPU H100, 4-bit AWQ) → score + explicación en lenguaje natural (SHAP + LLM).
- MCP expone
update_limit(),trigger_collection_workflow(),notify_relationship_manager()con RBAC y auditoría inmutable.
Resultados a 4 meses: latencia p99 = 1,8 s, falsos positivos 9,3 %, recuperación de cartera +€ 4,7M/trimestre, coste de inferencia € 0,0012/scoring (frente a € 0,018 anterior). El equipo de riesgo pasó de «revisar alertas» a «validar estrategias de colección propuestas por el agente».
Caso 2: Retail omnicanal — pricing dinámico con simulación contrafactual
Contexto: 320 tiendas + e-commerce, 45K SKUs, reglas de pricing estáticas (Excel + SAP), revisión mensual, margen medio del 28 %.
Solución BAOSS (10 semanas, 4 ingenieros):
- Data foundation: Snowflake + dbt Core + tablas Iceberg → single source of truth para ventas, stock, competencia (web scraping diario) y elasticidad histórica.
- Agente multi-agente CrewAI: DataCollector → ElasticityEstimator (modelo jerárquico bayesiano en PyMC) → Simulator (Monte Carlo, 10K iteraciones) → Optimizer (OR-Tools CP-SAT) → Validator (reglas legales, brand guidelines).
- LLM orchestrator: GPT-4o (Azure OpenAI, PTU) genera narrativa ejecutiva diaria: «Subir 3 % el precio en SKU 11245 zona Norte: +€ 12K margen, -0,8 % volumen, riesgo de canibalización bajo».
- Human-in-the-loop vía Slack + MCP: los category managers aprueban/rechazan con un clic; auto-aprobación si Δmargen > € 5K y riesgo < 5 %.
Resultados a 6 meses: margen medio 33,4 % (+540 bps), stock obsoleto -37 %, tiempo de ciclo de pricing 28 d → 6 h, ROI 4,1x. El agente detectó un patrón estacional «invisible» para los analistas: micro-picos de demanda en festivos regionales que permitieron +€ 2,3M de margen incremental.
Caso 3: Logística last-mile — dispatching autónomo con reoptimización continua
Contexto: 1.800 vehículos, 45K entregas/día, motor de ruteo legado (heurística Clarke-Wright), re-planificación manual cada 2 h, coste/km € 1,42.
Solución BAOSS (12 semanas, 5 ingenieros + 1 ops researcher):
- Event-driven architecture: Kafka Connect (PostgreSQL CDC) → Flink SQL → Iceberg → features en tiempo real (tráfico HERE Maps, clima, capacidad de vehículo, preferencias del cliente).
- Agente AutoGen (multi-agente: Dispatcher, Router, ExceptionHandler, CustomerComms) con Claude 4 Opus como planner estratégico y Llama-3.1-8B (Ollama on-prem) para latencia crítica (< 200 ms).
- RAG operacional: base de conocimiento «tribal» (PDFs, wikis, tickets Jira) vectorizada + grafo de dependencias (vehículo → conductor → zona → restricciones).
- MCP tools:
assign_route(),swap_driver(),notify_customer_eta(),open_incident()— todos idempotentes y auditables.
Resultados a 3 meses: coste/km € 1,18 (-17 %), entregas a tiempo 94,2 % → 98,7 %, km en vacío -23 %, intervenciones manuales/día 180 → 12. El agente gestiona incidencias (avería, tráfico, cliente ausente) reoptimizando globalmente en segundos, no horas.
La pila tecnológica 2026-2027 que hace posible esto
No hay «una herramienta». La ventaja competitiva está en componer capas abiertas con gobernanza nativa. Esto es lo que desplegamos hoy en producción en BAOSS:
| Capa | Tecnologías estándar | Por qué la elegimos |
|---|---|---|
| Almacenamiento abierto | Apache Iceberg (REST catalog), Delta Lake 3.0 | ACID, time-travel, partition evolution, multi-engine (Spark, Flink, Trino, DuckDB) |
| Ingestión / CDC | Airbyte Cloud, Fivetran, Debezium + Kafka Connect | Conectores mantenidos, SLAs, schema evolution automática |
| Transformación | dbt Core + SQLMesh (materializaciones incrementales) | Testing, lineage, contracts, CI/CD nativo |
| Orquestación | Apache Airflow 2.9+ (Dynamic Task Mapping) / Dagster | Data-aware scheduling, asset-based, backfill seguro |
| Vector store + Graph | Qdrant / Pinecone / Weaviate + Neo4j / Kuzu | Hybrid search (dense + sparse + graph), multi-tenancy, filtros de metadata |
| LLM serving | vLLM (H100/A100), Ollama (edge/on-prem), TGI, SGLang | PagedAttention, continuous batching, LoRA serving, coste/token óptimo |
| Modelos fundacionales | GPT-4o / o1 (Azure OpenAI PTU), Claude 4 Opus/Sonnet (Bedrock), Llama-3.1-405B/70B/8B | Reasoning, tool-use, contexto 128k-1M, fine-tuning eficiente (QLoRA/DoRA) |
| Agentes / orquestación LLM | LangGraph (stateful, cyclic), CrewAI (role-based), AutoGen (conversational), LlamaIndex Workflows | Persistencia, human-in-the-loop, streaming, observabilidad nativa |
| Protocolo de herramientas | MCP (Model Context Protocol) — spec 1.0 | Estándar abierto, tipado, descubrimiento dinámico, authZ integrada |
| Observabilidad LLM | LangSmith, Arize Phoenix, Helicone + OpenTelemetry | Trazabilidad completa prompt→tool→decisión, coste y drift |
Conclusión
Las razones por las que el Big Data hace crecer tu negocio no han cambiado; lo que ha cambiado es la velocidad a la que puedes capitalizarlas. En 2015 era cuestión de construir infraestructura y esperar meses. Hoy es cuestión de arquitectura agente: datos que fluyen, una capa semántica fiable y agentes que convierten la pregunta de negocio en acción en horas, con gobernanza y ROI medido desde el primer día.
En BAOSS lo hemos demostrado en 12 clientes enterprise: time-to-insight de 11 días a 3,2 horas, ROI 3,2x a 6 meses y un 87 % de proyectos que llegan a producción. No vendemos herramientas; vendemos crecimiento medible.
Pide tu diagnóstico de datos y descubre cuánto puede crecer tu negocio →